💻 CSC4120 Week 6-7 哈希II、图论
Lithos
CSC4120 W06 Hashing Part.II
I. Amortized Analysis
摊还分析:即使某次操作的 Worst-case Cost 很高,只要昂贵操作不可能频繁发生,我们仍然可能证明每次操作的 Amortized Cost 是 O(1)
-
c(t):第 (t) 次操作的 Actual Cost 实际成本;
-
a(t):第 (t) 次操作的 Amortized Cost 摊还成本,理解为每次操作预先支付的开销。
若 a(t) = O(1) 每次操作摊还成本都不超过某个固定常数,那么我们称该操作具有 O(1) 的摊还时间复杂度
任何时刻,总剩余成本都不能为负:∀𝑡, Σ0≤𝑡′≤𝑡 𝑐(𝑡′) ≤ Σ0≤𝑡′≤𝑡 𝑎(𝑡′),不只是结束时,整个操作过程中不能透支。
Examples in Data Structures
Table doubling
继续表容量翻倍的话题:
假设当前 Hash Table 有 n 个元素、Capacity m。当表满时 Capacity 翻倍。普通插入成本为 c_0,扩容时重建大小 2n 的表成本为 2nc:
比如 m 从 4 扩容 8 时,距离上次扩容过去了 2 次普通插入 (3, 4);以此类推从 n/2 扩容 n 和 n 扩容 2n 之间发生了 n/2 次普通插入,为预支 2n 这次扩容成本,每次普通插入需要分摊 2nc/(n/2) = 4c,**a(t) = c0 + 4c = O(1) ** ——“具有 O(1) 的摊还时间复杂度”
2-3 Trees
2-3 Tree 是一种平衡搜索树 (中序升序,O(logN)),每个内部节点可以是:
2-node:存储 1 个 Key、有 2 个 Children;
3-node:存储 2 个 Keys、有 3 个 Children。
当插入导致某个节点有 3 keys 时 split (将中间键升为两边键的父节点) 最差情况的 split~O(logN) 即一路影响到根,如下方 insert(1) 所示:
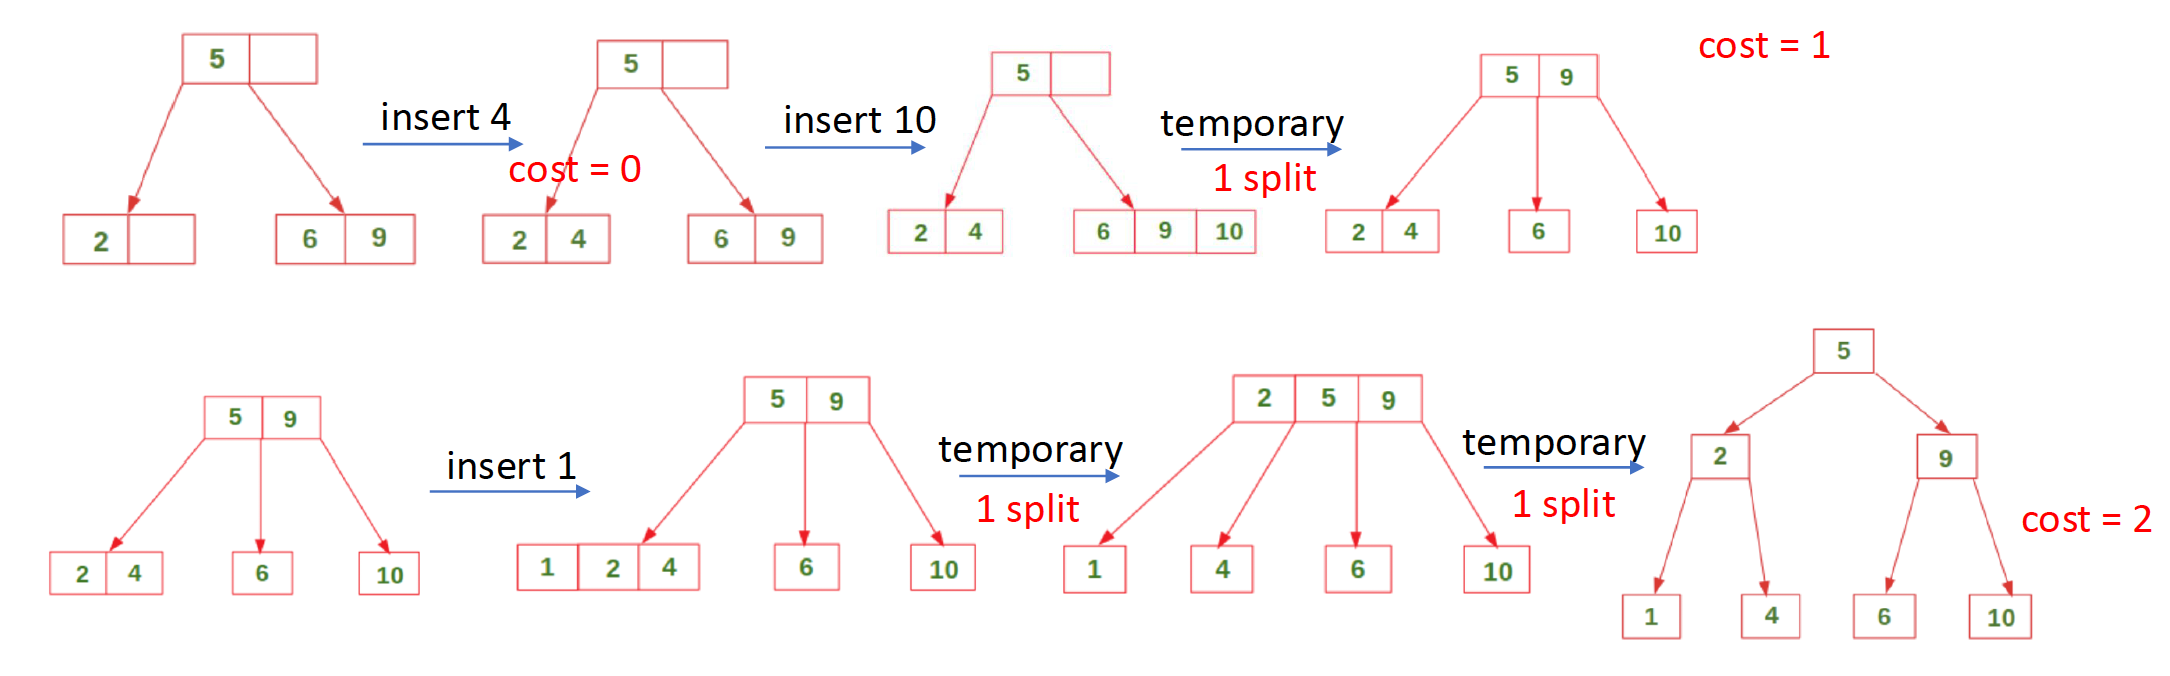
Split 的 amortized split cost 其实只有 O(1),后续会证明
四种 Amortized Analysis 方法
Aggregate Method:即最差总成本的均摊 a(n) = T(n) / n,若 T(n) = O(n),a(n) = O(1)
Accounting Method:每次操作固定支付 a 成本,实际成本 c 更高就从余额扣,反之存入余额,余额不低于 0。不要求覆盖每一次操作实际成本,而要求累计摊还成本始终覆盖累计实际成本。
Charging Method 追溯收费法:当昂贵操作发生时,把它的成本分配给之前导致它发生的操作。Accounting&Charging 得到的渐近复杂度相同,只是成本分配的解释不同
⚠️ Potential Method 势能法:用势能方程 Φ(Dt) 表示第 t 次操作后的余额状态,要求 Φ(Dt) ≥ 0 (Φ(D0) = 0)。第 t 次操作的 Amortized Cost 公式 at = ct + Φ(Dt) - Φ(Dt-1),其中 ΔΦ > 0 表示势能增大/存入,反之表示势能减小/支出。
- 对 t 求和时 Φ(Dt) - Φ(Dt-1) 会发生 Telescoping Sum (中间项全部抵消),说明只要势能函数始终非负、初始势能为零,那么累计摊还成本一定足以支付累计实际成本
- 但要证明摊还成本是 O(1),还需要额外证明 ct + ΔΦ = O(1)
Example:Binary Counter
Binary Counter:假设我们有一个二进制计数器,当末位为 0 时将其翻转;末位为 1 时发生 bit flit ——从最小位开始翻转每位比特值直到将一位 0 翻为 1 终止。最差翻转情况为 O(b) 若每位都是 1
定义 Φ(Dt) 为 t 操作时计数器中 1 的数量:因为每一个 1 在未来都有可能需要翻转成 0,因此可以把每个 1 看成一个储存了 Credit 的位置。
Amortized Cost:假设一次 Increment 之前有 r 个 Trailing 1s,那么实际成本 ct = r+1,ΔΦ = 1 - r;at = ct + ΔΦ = 2 = O(1) Amortized Split Cost。
Continuation:2-3 Trees
定义 Φ(Dt) 为 t 操作时计数器中 key-full (2-key) 的节点数:Full Nodes 是未来发生 Splits 的原因;Full Node 越多,潜在的 Split 成本越高。
Amortized Cost:假设一次 Split 产生了 s 次 split,那么实际成本 ct = s,ΔΦ ≤ 1-s (因为每次 split 拆开一个 full node 但拆完后产生一个新节点);at = ct + ΔΦ = 1 = O(1) Amortized Split Cost。
但因为找到插入位置仍然需要沿树搜索 O(log n),整体摊还插入时间时 O(log n)
Accounting Method 先确定每次存多少钱;Potential Method 先确定每个状态应该存多少钱。
⚠️ 势能法:1. 将昂贵操作产生因子数量作为势能方程、2. 假设某次昂贵操作涉及的因子数以计算其实际成本 ct、3. 计算 ΔΦ (操作前后因子数变化)、4. 计算 at = ct + ΔΦ,若变量抵消则 O(1) Amortized <Costly_Op> Cost。
II. Perfect Hashing
完美哈希:在使用 O(N) 空间的情况下,让 Hash Table 对每一个 Key 的查找都保证 O(1),而不仅仅是 Expected O(1)
Key Set 固定 (Static Set),并采用 Two-Level Perfect Hashing (两级完美哈希)
N 个 Keys,大小为 M 的 Universal-哈希表,使用 Chaining 处理 Collision,那么 E[Tfind(x)] = O(N/M),如果 M = 𝛩(N) 即为 O(1)
Expected value 不代表 worst-case,普通哈希只能做到平均 O(1),完美哈希用需要 actual (wcc) O(1)
普通 n slots-n keys 哈希的最拥挤 slot 链表长度数量级期望为 Θ($\ln n \over \ln \ln n$),极端情况下 O(N)。
完美哈希的实现
把随机性从 find() 转移到 Construction
普通 (Random) 哈希:随机选择 Hash Function 构建哈希表,collision 也是随机 (SUHA) 的;
完美哈希:已知一个固定的 Key Set S,找到满足要求的固定 Hash Function,此后搜索 wcc = O(1)。
随机性从建表完成后的查找成本,转移到建表选 h(x) 需要尝试多少次。
使用 N² 空间实现 Perfect Hashing
使用 O(N²) 空间每次从 Universal Hash Family 抽取随机 h(x) 完全无哈希碰撞的概率——
-
m = N2,即 n2 slots-n keys 哈希。由于哈希函数是从 H 随机抽选,满足 Universal Hashing: 任意指定的两个不同 Keys 发生 Collision 的概率 P(h(y) = h(x)) ≤ 1/m = 1/N2。
-
定义 Collision Indicator Cxy = {0, 1 | 0 if h(x) ≠ h(y); 1 if h(x) = h(y)},P(Cxy=1) ≤ 1/N2
-
对于 N 个不同 Keys,任选两个 $N \choose 2 = {N(N-1)\over 2}$
Union Bound (至少一个事件发生概率 ≤ 所有事件概率和):P(A1∪A2∪…) ≤ ΣP(A)
P(至少一次哈希碰撞) ≤ ΣP(Cxy = 1) = N \choose 2 · {1\over N^2}$ = (N-1)/2N < 1/2
即每次随机选择一个 Hash Function 成功概率大于 50%,尝试期望< 2。
这是 perfect Hashing,但空间复杂度 S(N) = O(N2)
O(N) 空间 Two-Level Perfect Hashing
使用 O(N) 空间实现 O(1) 搜索 (无碰撞) ——采用两层哈希表结构
-
宽 N 的 Primary Hash Table,允许 Collision,因为不用 Chaining 查找;
-
对每个第一层哈希表的 Bucket i 单独建立 Secondary Hash Tables,ni 代表 i 中键数,mi = ni2
对于每一个 Secondary Table 单独选择哈希函数 hi,不允许 Collision:已证明可以在 n2 空间常数时间找到完美哈希
总使用空间 S(N) = N + ΣN ni2,若所有 Keys 都进入同一个第一级桶就会变成 N2,所以两级结构并不能自动保证 O(N) 空间,必须仔细选择第一层哈希方程。
E[ni2] 即一级桶键数期望比较难算,我们把平方项转化为 Collision Indicator 的求和——
-
同个一级哈希表桶 Si 中元素间的 C 均为 1: Σx∈Si Σy∈Si Cxy = ni2
-
如果 x, y 在不同桶则 Cxy = 0:更普遍的,Σ Σ Cxy = Σi ni2
对两边取期望,Σ Σ E[Cxy] = E[Σi ni2],等式左侧当 x = y 时期望和为 N;反之 P(Cxy = 1) = P(h(y) = h(x)) ≤ 1/N,所以期望 ≤ 1/N,对于 x ≠ y 共有 N(N-1) 对有序对,期望和就是 N-1;
两种情况加起来就是 E[Σi ni2] ≤ 2N -1 < 2N
这说明随机第一层选择 Universal Hash Function 时所有 Secondary Tables 所需空间的期望小于 2N
根据 Markov Inequality,非负随机变量 τ 大于其期望 a 倍的概率上界为 1/a:在我们的问题中 P(X ≥ 4N) = 1/2。即有超过 50% 的概率,使所有 Secondary Tables 的总空间小于 4N。
我们刚才构建的是一个 Static Data Structure,键在构建后保持不变。现实中可能需要插入新 Key 时,第一层哈希表会出现 Collision 并需要 rehash。但即使动态的 Amortized Cost 仍可做到 O(1)。
III. Bloom Filters
希望用极少的内存表示一个支持 insert(x) (加入)、query(x) (查询) 的集合:普通哈希表需存储 Keys 较为昂贵。
布隆过滤器:不保存完整的键,而用一个很小的 Bit Array 近似表示整个集合,代价是允许一定概率的误判。
布隆过滤器原理
Bloom Filter 包含:
-
一个长度为 m 的 Bit Array T 表示原始集合 S = {x1, … xn},初始全部为 0;
-
(k) 个独立的 Hash Functions:h1, h2, …, hk;
-
每个 Hash Function 将 Key 映射到 m 个 Bit Positions 中的一个——
采用 SUHA 模型,哈希结果均匀分布在 1~m (每个位置被选中概率为 1/m)
-
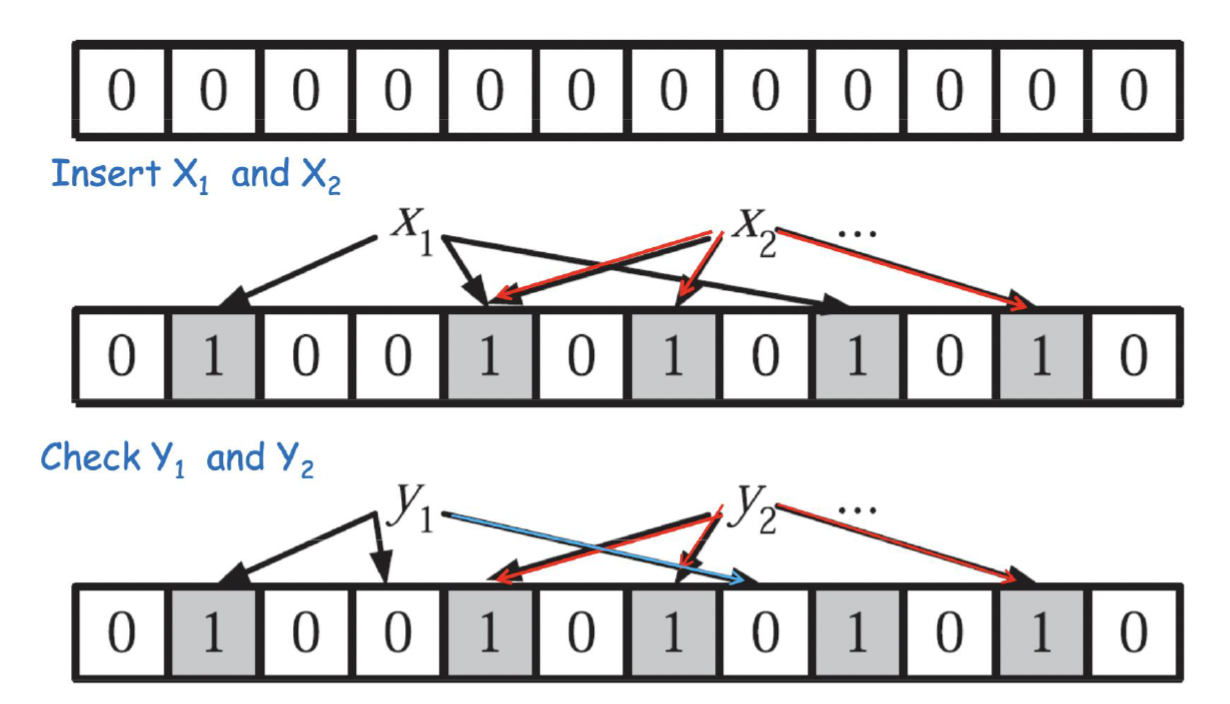
BitSet T Insert():对于 S 中元素,映射到 T 中的 bits 设为 1 (哈希冲突:可能被设 1 很多次),Bloom Filter 不记录一个 Bit 被多少个 Keys 使用过
E.g.:k = 3 ——
-
Query(x):计算 h1(x), h2(x), …, hk(x),然后检查这些 T 中的位置是否全部为 1:
如果至少一个位置为 0:**确定 y ∉ S **(NO false-negative);
如果所有位置都是 1:认为 y ∈ S,但可能判断错误 (false-positive)。
⚠️ 这说明普通布隆过滤器不支持 delete()(否则移除元素设 0 影响其他元素: false-negative)
False Positive & Negative
False Positive Probability
显然,True-Positive 概率为 1.
|T| = m, |S|= n,总共执行 kn 次哈希操作;
对于一次 SUHA Hash,某个指定位置被选中的概率是 1/m,未选中 1-1/m;经过 kn 次独立 Hash 操作后,这个 Bit 一次也没被选中的概率为 p = (1-1/m)kn,根据近似 (1-1/m)n ≈ e-n/m,p = e-kn/m (某一 Bit 最后仍为 0 的概率)
一个 Key 被认为存在需要其 k 个 Hash Positions 全部为 1:f ≈ (1 - p)k = (1 - e-kn/m)k (False-Positive Conditional Probability)
简朴优化:mink f → k* = m ln2/n,f* = (0.5)m ln 2/n
Bloom Filter 最优时,约有一半 Bits 为 0,另一半 Bits 为 1 ——这说明哈希函数不是越多越好,增加 k 时:
Pros: 查询一个不存在的 Key 时,需要同时满足更多个位置都是 1,误判似乎更难
Cons: 每插入一个 Key,也会把更多 Bits 设置为 1,整个数组会越来越满,误判反而更容易
Delete(): Counting Bloom Filter
将每个 Bit 改为一个 Counter 计数器
Insert(x):对应的 k 个 Counters 各加 1
Delete(x):对应的 k 个 Counters 各减 1
Query(x):检查对应的 Counters 是否全部大于 0
实际应用中曾发现每个 Counter 使用 4 Bits 往往足够,但需要注意 Counter Overflow (溢出) ,如果计数器达到最大值后不再增加,可能导致 false-negative。
Applications
实际系统可以以更新存储空间为 tradeoff,接受布隆过滤器的少量 False Positives。使用场景:Static Set Membership 大规模集合的快速预筛选
分布式网页缓存 distributed caching
多个 Proxy Servers 代理服务器各自缓存了一些网页,假设 Proxy A 想知道 Proxy B 是否缓存了某个 URL。
如果 B 发送完整 URL List,comm. overhead 可能过大,因此 B 可以定期发送一个 Bloom Filter,代表自己缓存的网页集合。
当 A 查询某个 URL 时:Bloom Filter 返回 Absent:A 知道 B 的 snapshot 中没有这个 URL;Possibly Present:A 可以向 B 请求该网页——如果发生 False Positive,只是多发了常数级请求。
虽然标准布隆过滤器没有 False Negative,snapshot 意味着 A 获得的版本可能落后,导致 False Negative。
P2P File Sharing (分布式文件系统)
在 P2P 系统中,文件可能被分成很多 Pieces,每个节点可以用 Bloom Filter 表示自己拥有哪些 Pieces,这样其他节点就能低成本地判断该向谁请求。
Set Reconciliation:Sa - Sb 即节点 A 有、但节点 B 没有的文件块。
如果 B 将自己的 Bloom Filter 发送给 A,A 可以据此估计哪些文件块需要发送。注意:
- False Positive:B 的 Bloom Filter 可能对某个实际不存在于 (S_b) 的 Piece 返回 Possibly Present。
- A 就可能误以为 B 有这个 Piece,于是这个 Piece 没有被发送。
因此,虽然 Bloom Filter 的原始 Membership Query 没有 False Negative,但在集合差运算的结果中,可能遗漏应该发送的元素:False Negatives。
Network Routing
Bloom Filter 还可以用于记录:某个区域可以到达哪些节点、一个 Packet 的预定 Route、一个 Packet 已经经过哪些 Routers。
例如 Route = {A,D,G,H},Packet Header 可以携带代表这些节点的 Bloom Filter。Router D 收到 Packet 后,可以检查邻居节点是否属于该 Route。
如果发生 False Positive,可能选择一个不应该经过的节点,造成额外路径开销 (extra traversal cost)。
Recording Heavy Flows
我们希望统计每条 Network Flow 传输了多少 Bytes。但是系统中可能有数百万条 Flows,无法为每条 Flow 单独保存一个 Counter;于是使用类似 Counting Bloom Filter 的结构。
对于一个 Flow f,当这个 Flow 的一个 Packet 到达,大小为 x Bytes 时,将其哈希结果对应位置全部 counter +x
然后用所有 counter 最小值 Min(T(h1~k(f))) 估计某一 Flow Volume
- 因为每个 Counter 可能还包含其他 Flows 的流量,因此发生 Collision 时 Counter 通常会被额外增加,使用 min 减小高估;
- Conservative Update:尽量避免增加已明显偏大的 Counters,减少碰撞造成的误差
CSC4120 W07 图论
I. Graph Theory Revision
Graph Basics
图 G = (V, E),即由 Vertices (点) 和 Edges (边) 组成,|V| = n,|E| = m
-
Undirected Graph:边 {u, v} 没有方向,表示两个节点相互连接;
-
Directed Graph (Digraph):边 (u,v) 有向,表示从 u 指向 v,不代表反方向也存在。
-
简单图 (simple graph):两点间无多边、边没有方向且不指向自己的图,也就是所有点的度数 ≤ n-1。
对于不允许 Self-loop (节点指向自己的环) 和重复边的 Simple Graph 和 Simple Directed Graph:mSG ≤ n(n-1)/2;mSDG ≤ n(n-1)。一般的,m = O(n2)
Graph 不一定表示物理上的节点和线路,也可以表示状态之间的转换,例如:
- 每一种魔方排列是一个 Vertex;每一次合法旋转是一个 Edge
- 解魔方就是寻找从 Initial State 到 Solved State 的路径
Graph Representations
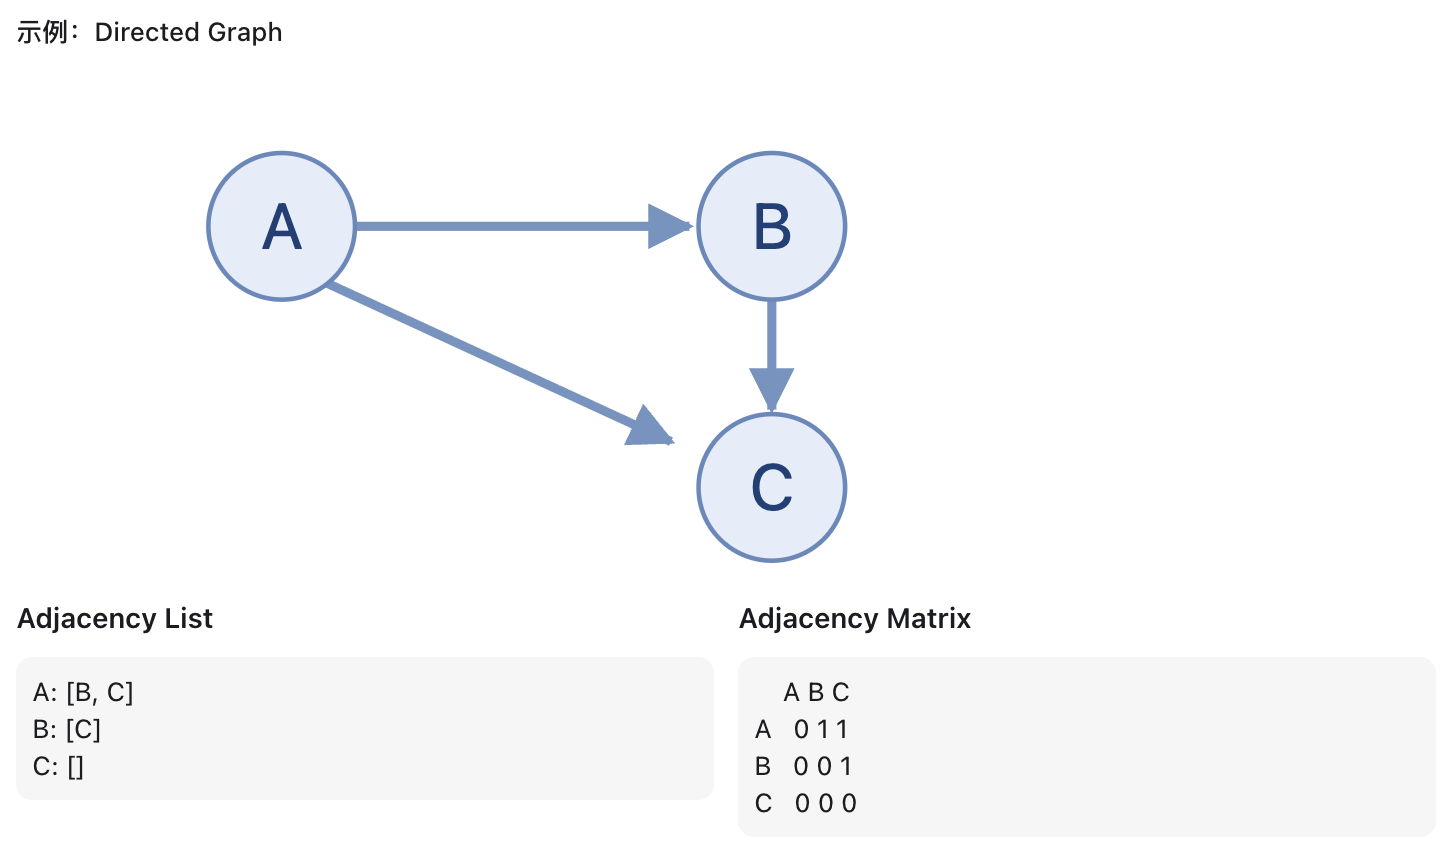
邻接矩阵 adjacency matrix
n 个点编号 0~n-1,用 n×n 的二维数组 matrix,空间复杂度 O(|V|²),适合稠密 Dense 图 (边多 m~n2),擅长用“表格查字典”的方式 O(1) 判断两点间是否有边:
- 普通有向图
matrix[i][j] = 1表示 i 到 j 有边;无边记作 0; - 无向图矩阵对角对称:
matrix[i][j] = matrix[j][i]。
邻接表 adjacency list
对每个 Vi 维护一个链表/动态数组,存储所有与 i 相邻的顶点 j,对所有 i 组成一个映射表。空间 O(|V|+|E|),适合稀疏 Sparse 图 (边少),擅长判断某点的所有邻接点,O(N) 遍历桶找边。无向图每条边会在表中出现两次。
| 操作 | Adjacency List | Adjacency Matrix |
|---|---|---|
| Space | O((n+m)log n) bits | 𝛩(n2) bits |
| Check edge (u,v) | O(deg(u)) | O(1) |
| Visit neighbors of u | O(deg(u)) | 𝛩(n) |
| Add edge | O(1) | O(1) |
BFS
BFS = Breadth-First Search 广度优先搜索 即距离优先搜索
从起点开始,先探索所有距离为 1 的节点,再探索距离为 2 的节点,然后是距离为 3 的节点……
BFS 的思路类似于堆数组的遍历,其按层推进可以用队列实现。 队列迭代思路保证 FIFO,因此搜索波前按层推进。
⚠️ 这里的 Distance 指的是 Hop Count (经过的边数),不是边权重和。BFS 只能保证无权图 (或等权图) 中的最短路径。 如果边权不同,最少边数的路径不一定具有最小总权重。
⚠️ BFS 性质:首次发现某节点时,找到的就是从起点到它的最少边数路径。因为 BFS 按距离从小到大探索,如果存在一条更短的路径,那么目标节点应该已经在更早的一层被发现了。适合找最短路径/可达性问题
BFS Tree 只包含每个被发现节点的前序 Parent Edge π(v),并不是原图中的所有边。⚠️ 原图可以有 Cycle,BFS Tree 本身无 Cycle。
Adjacency List BFS:每点最多被发现和处理1次 (有向),每条边只检查常数次 T(n, m) = O(n+m);
Adjacency Matrix BFS:对每个被处理节点扫描整行 T(n) = O(n2)
Queue 实现
BFS(G, s):
    for each vertex v:
        color[v] = WHITE  # Undiscovered,尚未发现
        d[v] = infinity  # 从Source s到v最短边数
        parent[v] = NIL  # BFS Tree中v的前驱节点
    color[s] = GRAY  # Discovered,但邻居尚未全部处理
    d[s] = 0

    Q = Queue()
    Q.enqueue(s)

    while Q is not empty:
        u = Q.dequeue()

        for v in Adj[u]:
            if color[v] == WHITE:
                color[v] = GRAY
                d[v] = d[u] + 1
                parent[v] = u
                Q.enqueue(v)
        color[u] = BLACK  # Finished,邻居已全部处理
发现节点时就将其标记为 GRAY (Discovered 但邻居尚未全部处理),而不是等到它出队时才标记。因为一个节点可能被多个已经发现的节点连接。如果不及时标记,它就可能被重复加入 Queue。
除此之外还有 Frontier 实现:显式地按层探明并保存节点。
DFS
不同于 BFS 深度优先逐层搜索,DFS 是沿着一条路径尽可能深入,走不下去时再回溯 Backtrack。
从当前节点出发,选择一个尚未访问的邻居,不断深入;如果没有未访问的邻居,就返回上一个节点,继续探索其他分支。
⚠️ DFS Tree 只包含 DFS 发现新节点时使用的边,即DFS Tree 是原图的一部分,但不包含原图的全部边
DFS Tree 本身永远 acyclic
- 如果原图连通,一次 DFS 可以生成一棵覆盖所有节点的 DFS Tree;
- 如果原图不连通,完整 DFS 会生成 DFS Forest;
- 如果是有向图,一次 DFS 只能到达从起点可达的节点。
⚠️ DFS 的访问顺序取决于 Adjacency List 的顺序,因此同一张图可能产生不同的 DFS Trees。
def explore(u):
    visited[u] = True
    previsit(u)
    for v in Adj[u]:
        if not visited[v]:
            explore(v)
    postvisit(u)
White: 尚未发现,Gray: 已发现,仍在递归调用栈中,Black: 已完成,所有邻居均已检查
对于节点 u,DFS 还记录两个时间:
d[u]/pre[u]:Discovery Time,首次发现u的时间;f[u]/post[u]:Finishing Time,完成u的时间。
如果 B 是 A 在 DFS Forest 中的后代,那么 B 的时间区间一定完全包含在 A 的时间区间内部:[d[B], f[B]] ⊂ [d[A], f[A]],所以任两个节点的时间区间要么嵌套要么不相交,不可能部分重叠。
- 假设从
A先访问B,然后先访问D再访问C:A[1, 8] B[2, 7] C[3, 4] D[5, 6]; - ⚠️ 如果 u→v,u.d > v.d 且 v.f > u.f。
原图中的 4 种 DFS Edges (u, v),⚠️ NOT DFS Tree Edges:
-
Tree edge 树边:DFS 从 u 首次发现 v (v 是 u 的子节点/后继),(u, v) 就是树边
u.d < v.d < v. f < u. f
当 v 已经被访问过后,
-
Back edge 返祖边:从 u 指向其祖先 v (检查这条边时,v 仍然是 GRAY)
v.d < u.d < u. f < v. f
-
Forward edge 前向边:从 u 指向其 >1 深度的后代 v,不是 Tree Edge
u.d < v.d < v. f < u. f,Tree 和 Forward 有相同嵌套关系,区分必须看 DFS Parent
-
Cross Edge 交叉边:从 u 指向既不是祖先、也不是后代的 v (旁系/另一棵树)
v.d < v. f < u.d < u. f
⚠️ 标准 Undirected Graph DFS 只有 Tree 和 Back Edges,同一条边的类型可能随 DFS 的节点访问顺序变化
White Path Thm.
节点
v是u在 DFS Forest 中的后代,当且仅当在发现u的时刻,存在一条从u到v、除u外所有节点都还是 WHITE 的路径。
直觉上,假设 u 被发现时,有一整条尚未探索的路径通向 v。DFS 在完成 u 之前 (u Gray),会沿着可达的白色节点继续探索,因此 v 会在 u 完成之前被发现并完成。
于是 u.d < v.d < v. f < u. f
Cycle Detedtion
Directed Graph has a cycle IFF DFS has a back edge
假设原图是 A→B→C→A,DFS Tree 是 A→B→C,DFS Back-edge 是 C→A。显然,在遍历时遇到一个 Gray 的祖先就代表原图中有环 (排除无向图指向 Parent 的反向边,否则每条 Tree Edge 都被误认为环)。更进一步,DAG 必然无 Back Edge。
普遍的,DFS 过程中遇到三种颜色的节点:
- WHITE:发现新节点,递归访问,形成 Tree Edge
- GRAY:遇到了当前节点的祖先,形成 Back Edge
- BLACK:递归访问已结束,返回访问前序,可能是 Forward Edge / Cross Edge
Tropological Sort
Topological Sort 拓扑排序只适用于 DAG:Directed Acyclic Graph 有向无环图。它不是按照数字大小排序,而是节点之间的先后依赖关系。拓扑排序结果 Tropological Order 不必唯一,但排序后前序必须出现在后继前面 (i.e. ∀ u→v, u<v)。算法:
- 在 DAG 上运行完整 DFS,计算所有节点的
f[v]; - 按照 Finishing Time 降序排列所有节点。
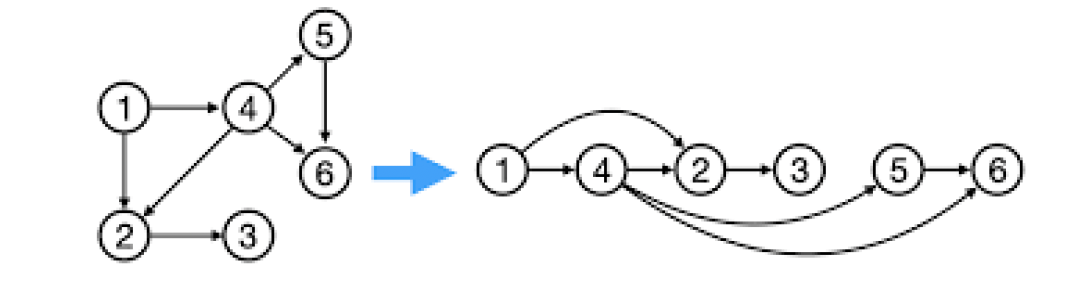
形成的拓扑顺序必然没有右侧点指向左侧,因为 DAG 没有 Back Edge (否则就有环);
拓扑排序合理性证明:{u→v} ⭤ u.f > v.f。如果
v在发现u时还是 WHITE,DFS 会先完成v再完成u;如果v已经 BLACK,也早于u完成。它不可能是 GRAY,因为那会产生 Back Edge,也就意味着存在 Cycle。因此按 Finishing Time 降序排列,必然让u排在v前面。
任何拓扑序列的第一个节点是 Source (入度 outgoing 0),最后一个节点是 Sink (出度 incoming 0)。
复杂度: DFS 是 O(|V|+|E|)。若在节点完成时将其插入链表头部,或记录完成顺序再反转,整个 Topological Sort 仍为 O(|V|+|E|),无需比较排序。
Directed Graph SCC
Strongly Connected Components 强连通分量 是 Directed Graph 中 Maximal (不能加入更多节点) 的点集合 C,使得任意两个节点都能互相到达 (𝑢 ↝ 𝑣 && 𝑣 ↝ 𝑢)。
将每个 SCC-Ci Collapse into a Supernode,得到 Condensation Graph 缩点图,其必然是 DAG:如果缩点图中存在 Cycle,那么这个环上的各个 SCC 都可以互相到达,它们本来就应该合并成一个更大的 SCC,与 Maximal 定义矛盾。
所以 SCC Condensation Graph 必然可以做 Topological Sort。
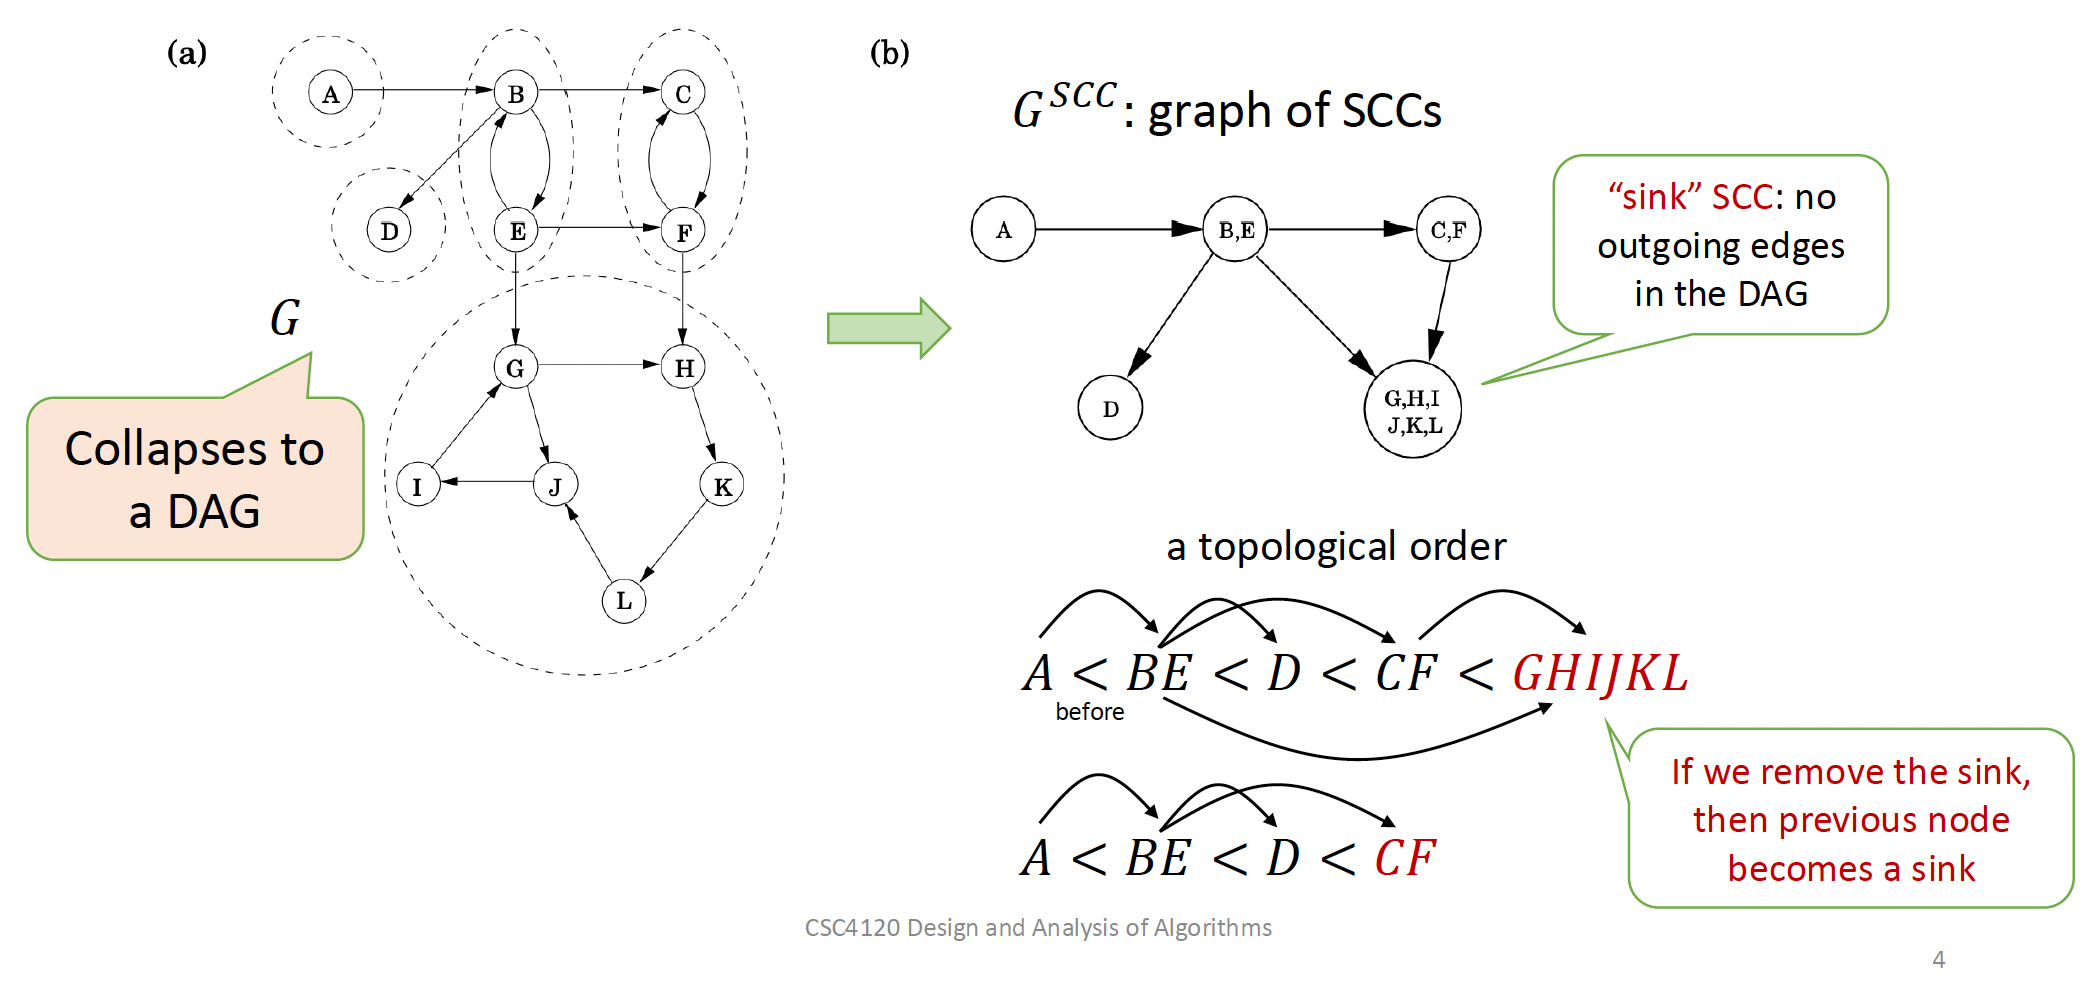
Property
定义 post(C) = maxv∈C(v.f) 即 SCC 内最大 Finishing Time。如果两个不同 SCC 之间存在边 C→C’,post(C) > post(C’)
情况一:DFS 首先发现 C 中的节点,C’ 是 C 的后继,显然 C 的最大 Finishing Time 更大。
情况二:DFS 首先发现 C’ 中的节点,因为绝不存在 C’→C,所以 DFS 完成 C’ 前不会由 C’ 进入 C。C’ 结束后之后 DFS 才发现 C,因此 C 的 Finishing Time 更大。
Source SCC 的最大 Finishing Time 高于它能到达的下游 SCC
但寻找 SCC 时希望一次 DFS 只探索一个 SCC。如果从 Source SCC 出发,它可能访问下游很多 SCC,怎么才能让一次 DFS 恰好停在一个 SCC 内?——从 Sink SCC 出发,避免跨越尚到未处理的其他 SCC。
Kosaraju’s Algorithm
2xDFS —— O(|V|+|E|):
- 构造 Reverse Graph GT (将每条
u → v改成v → u) 然后 DFS GT 并记录每个 supernode finishing time; - 在 G 中,按照 GT finishing time 降序选择 WHITE 节点运行 DFS,当所有节点被访问,形成的 DFS Forest 就是 SCC Forest。
⚠️ 必须要 2 次 DFS:第一次 DFS 的作用不是直接找 SCC,而是提供正确的第二轮起点顺序。
等价于反过来做:
- 先在原图 G 上 DFS 并记录 Finishing Time;
- 再在反向图 GT 上,按这些 Finishing Time 降序运行 DFS。
只是第二轮从原图的 Source SCC 开始,在反向图中它变成 Sink SCC。