💻 CSC4120 Week 3-4 排序算法,树与堆,以及模运算
Lithos
CSC4120 W03 Sort/Search Algs. & Modulo
I. Sorting and Searching
Comparison Lower Bound 比较算法的下界
之前见过的 Merge Sort、Insertion Sort 等 排序算法 都是 comparison sorts。
这类算法判断元素顺序只能依赖:ai ≤ aj ?
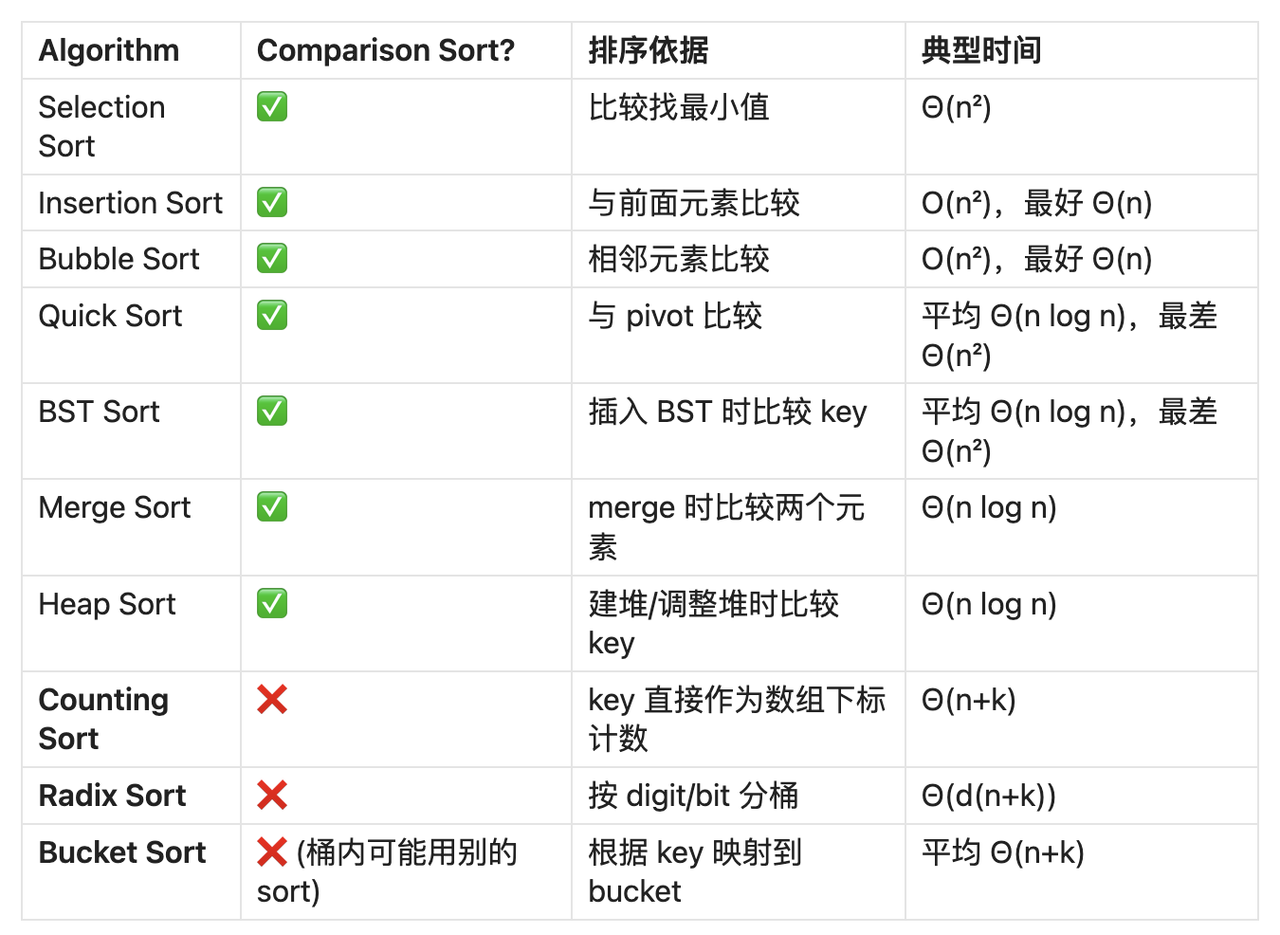
以上我们见过的比较算法做排序最快时间复杂度是 O(nlogn),这也是其 worst-case lower bound:Csort = Ω(nlogn)。我们用决策树证明。
Decision Tree 决策树
使用比较算法排序 n 个数 a1 , … an,每一步比较记作 i:j (i, j ∈ {1, 2, … n},对比 ai 和 aj),作为一个节点,就可将所有可能的执行过程画成二叉树。比如对于 n=3
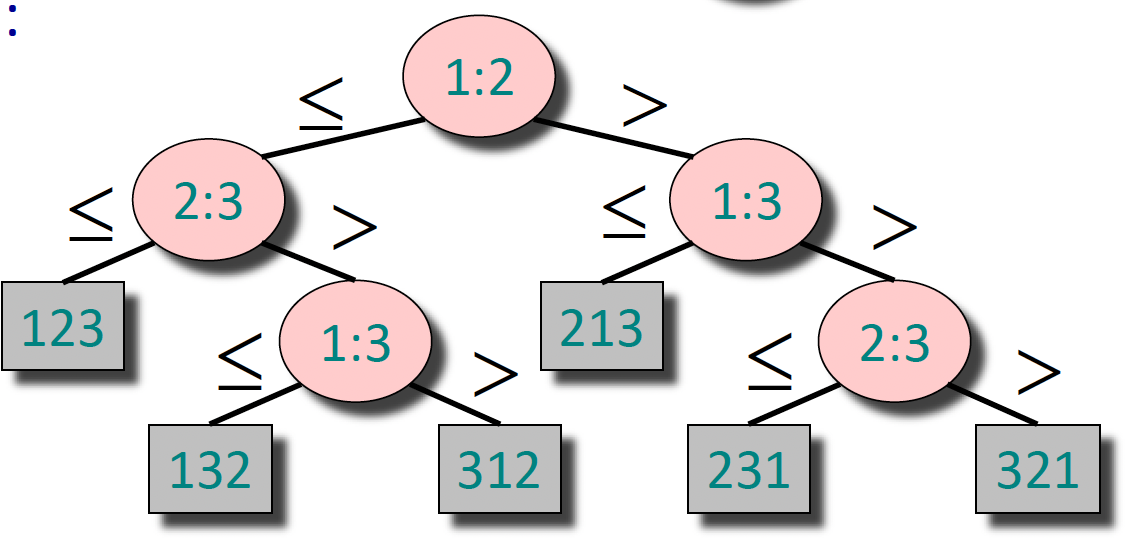
在决策树中,选择的分支由比较结果决定 (结果 ≤ 走左分支),n! 个叶分别代表一种排序结果 π 使得 aπ(1) ≤ aπ(2) ≤ … < aπ(n) 成立。
因此,path length (路径长度) 就是排序次数,即经过多少个边。最差情况就是最长路径,即树高。
CSC3060:对于 N 个节点,高为 h 的二叉树:节点最多 N ≤ 1+2+4+…2h = 2h+1-1,所以N∈[h+1, 2h+1-1];反过来可以求出 h 的下限,h∈[⌈log2(N+1) - 1⌉, N-1]
⚠️ CSC4120:排序 n 个元素的决策树满足 L ≥ n! 个叶,且高为 h 的二叉树须有 L ≤ 2h,缩放 n! ≤ 2h,所以 h ≥ log2(n!),根据 Stirling’s approximation $n!≈ \sqrt{2πn}({n\over{e}})^n$ → log(n!) ≈ Θ(nlogn),故 h = Ω(nlogn)
这个结果限制了最优情况下 (平衡二叉树) 树高的数量级下限,意味着不存在 O(n) 的比较排序算法
Binary Search Tree
BST (中序遍历 = 从小到大) 也可以用决策树确定下界:
Binary Search 相当于在一个有序数组 A[0] < A[1] < … < A[n-1] 中寻找 k,结果可能是 0~n-1 和不存在共 n+1 种——
L ≥ n+1,且 L ≤ 2h,缩放 h ≥ log2(n+1) → h = Ω(logn)
这说明了 BST 的 O(logn) 已经是渐进时间复杂度最优解
线性时间的排序算法
考虑排序 n 个小整数 (严格来说是取值域 ≤ nc),在不比较的情况下就不存在 Ω(nlogn) 的壁垒
Counting Sort
如果确定 ∀ i ∈ Sort[n],i ∈ [0, k-1],在 k 不大的情况下,可以建立 k 个桶:B[0] ~ B[k-1],并扫描 Sort[n] 将元素按 x → B[x] 放到桶里,然后按 bucket index 顺序输出桶 (通常是链表) 得到排序结果。
for j in range(n):
    B[Sort[j]].append(Sort[j])
output = []
for i in range(k):
    output.extend(B[i])
初始化 k 个桶需要 Θ(k),遍历待排序数组 Θ(n),最后遍历桶输出 $\sum_{i=0}^{k-1}(1+|B[i]|)$ —— T(n, k) = Θ(n+k+(k+n)) = Θ(n+k),IFF k = O(n), T(n, k) = Θ(n)
如果 n = 100, k = 1012,Θ(n+k) = Θ(1012) 非常糟糕——value range is critical
Radix Sort
那如果整数范围比 n 大得离谱怎么办?
与其给取值域内每个整数做一个桶,我们把数字拆成 digits:x = ad-1kd-1 + … + a1k + a0 → ad-1ad…a0,ai ∈ {0, … , k-1}。⚠️ 这里 k 是 radix/base:也就是每个 digit 有多少种可能值 (k=10 就是逐位比,k=100 两位一比)。
⚠️ Tradeoff (权衡):k 越大 → 每一位能表达的信息 ↑ → 需要的位数 d ↓;但每一位可能的取值数量 k ↑ → 每轮 Counting Sort 越贵。
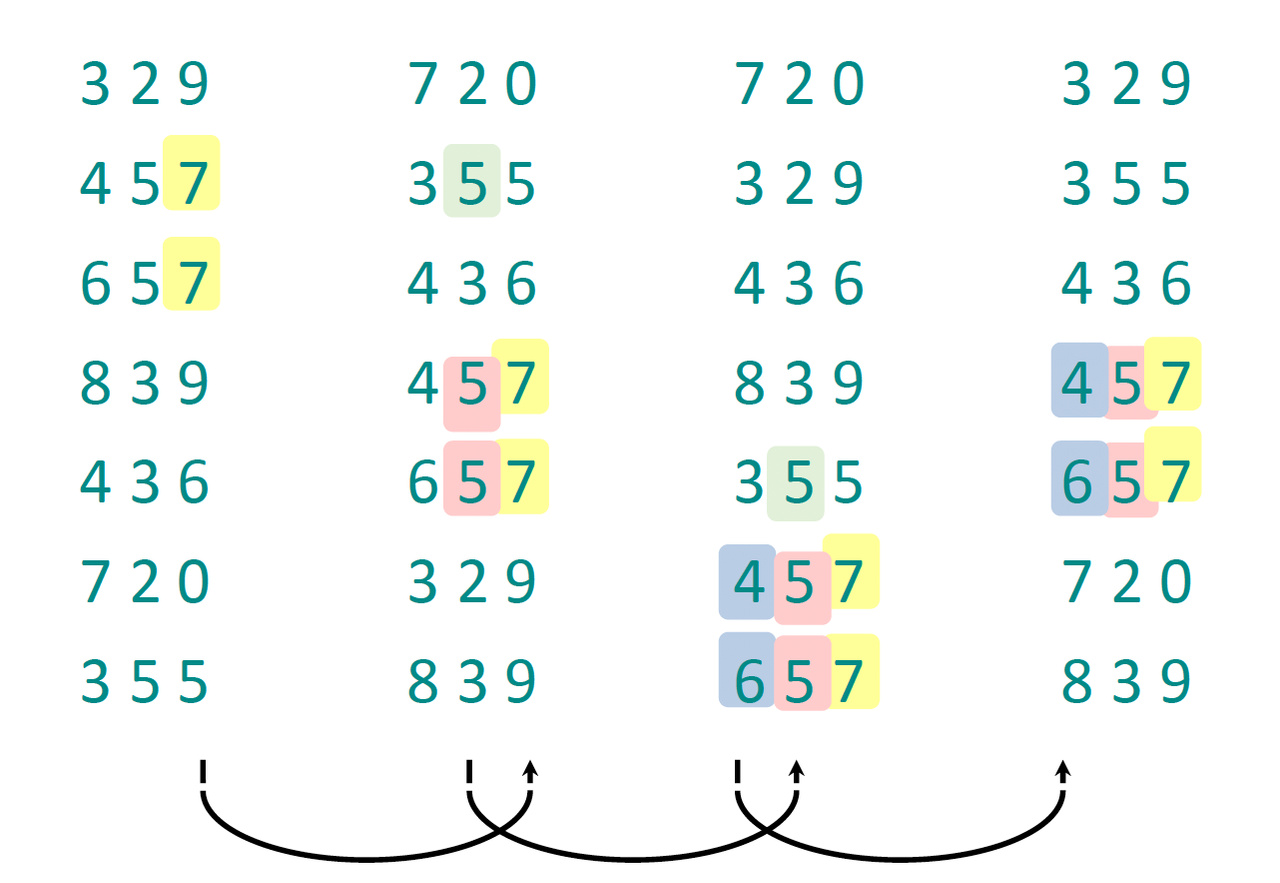
排序逻辑:Least Significant Digit first 从个位开始逐 base 排,必须保证 stable sort ——如果两个数字当前 digit 相同,必须保留它们之前按照低位形成的顺序。
这可以用数学归纳证明:前 t-1 个 low-order digits 已经正确排序,再 sort digit t —— digit t 不同: 当前 stable sort 直接确定正确顺序。digit t 相同: stable sort 保留之前由低 t-1 digits 确定的正确顺序……
假设 n 个整数,每个整数<M,使用 base-k
-
那么需要 d = logkM digits
-
每个 digit 的可能值 ∈ [0, … , k-1]
-
若每一个 base 分别使用 Counting Sort:Θ(n+k)
→ T(n) = **Θ((n+k) logkM) ** 该函数在 k = n 时最小:Θ(nlognM) = Θ(n)
普遍的,M ≤ nc (c > 0) 时 lognM ≤ logn(nc) = c → T(n) = Θ(nc) = Θ(n)
II. Heaps
堆的抽象定义
一个 object 可以抽象成 x = (x.key, x.data)
算法通常不需要不停操作整个 data,而是用 key (键) 来代表这个对象。搜索、插入、比较,本质上都针对键。
比如任务调度:(key = priority,data = 具体任务)。我们比较 priority,就知道哪个任务应该先处理。
这就是为什么 Heap 堆 又叫 Priority Queue 优先队列。
堆的抽象定义:堆是 “按优先级处理元素”,但无需所有元素整体排序的数据类型。典型模式是:不断插入新任务 (元素),然后每次取出当前最小或最大的任务处理,比如排序、打印机队列、操作系统调度、路由计算等。
支持:𝐼𝑛𝑠𝑒𝑟𝑡(𝑆, 𝑥) , 𝑀𝑎𝑥(𝑆) , 𝐸𝑥𝑡𝑟𝑎𝑐𝑡_max(𝑆), 𝐼𝑛𝑐𝑟_𝑘𝑒𝑦(𝑆, 𝑥, 𝑘)(或者 min)
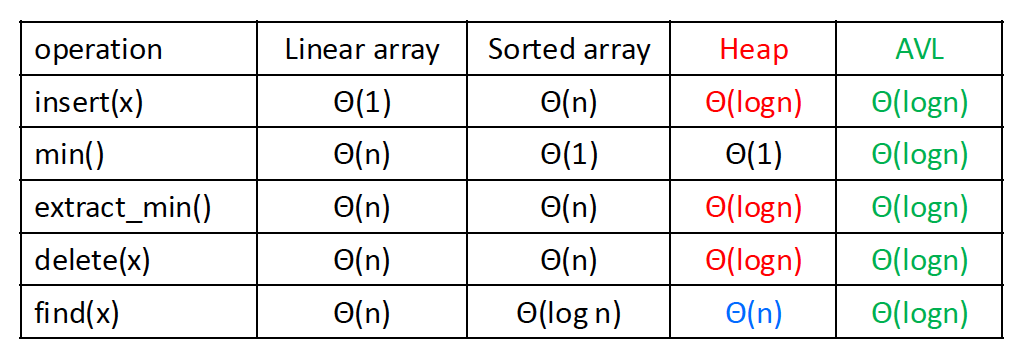
相比数组,堆根本不需要把所有元素完全排序,只维护有限的有序性,让最大/最小元素特别容易找到。
堆的重要结论
Heap = an array visualized as a nearly complete binary tree—— ⚠️ 数据格式本质是数组,逻辑与完全二叉树有关。
完全二叉树:除最底层外,每一层都满且最底层的叶都连续地靠左排列。
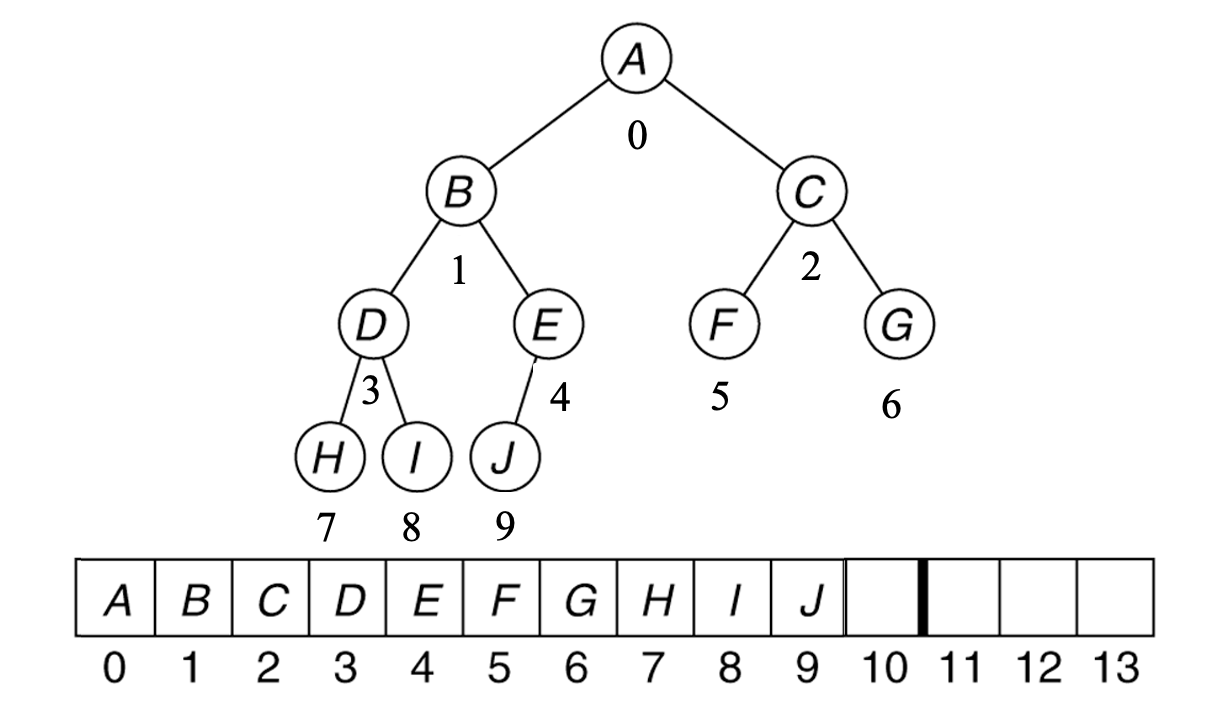
Heap(-order) Property 堆的局部有序性:对最小堆 (MinHeap) :父 ≤ 子节点,往根方向值递减,最小值永远在根。最大堆 (MaxHeap) vice versa。⚠️ 堆只保证 “父子有序”,不保证整棵树像 BST 那样左右有序,所以中序遍历不会得到排序序列。
⚠️ 并非所有数组元素都必须属于当前 heap,heap_size 规定数组中属于堆 (有堆的有序性的部分)。比如 heap_size = 7 表示 Arr[1, …, 7] 属于堆。后续的 Heap Sort 会用到缩小 heap_size,扩大有序数组的方法排序。
父子关系
内存里只有 (动态) 数组,不需要保存 Node 或 Pointer 结构。仅凭数组下标就能知道父子关系——
⚠️ 如果以 1 为根:parent(i) = ⌊i/2⌋;left(i) = 2i;right(i) = 2i+1;
如果 i > n/2 则说明它没有子节点,一定属于叶。
高度与复杂度
二叉树的高度 h 等于最长路径经过边的个数,严格等于 ⌊log2N⌋,所以树高是对数级。这就是堆操作能做到 O(log N) 的根本原因。
证明:完全二叉树最高情况最底层仅一个叶,最低情况恰为满二叉树:1+2+4+…2h+1 ≤ N ≤ 1+2+4+…2h → 2h ≤ N ≤ 2h+1-1 → h ≤ log2N < h+1 → O(logn)
维护 Heap
从乱序数组出发转为堆 O(n),修复单个局部不合法 O(logn),插入/删除点 O(logn),堆排序 O(nlogn)(比较算法下界)。
Fix a Single Violation
例如左下的结构,数组的第二项 4 违反 MaxHeap-order:
           16               16              16
          /  \             /  \            /  \
        [4]   10    →    14    10     →  14    10
        / \   / \       / \    / \      / \    / \
      14   7 9   3     4   7  9   3    8   7  9   3
     / \              / \             / \
    2   8            2   8           2   4
对于单一违反堆性质的非叶元素,使用递归下滤 siftDown:循环交换自己与左右孩子的较大项,直到左右孩子都比自己小。⚠️ 每次交换先要确定左右孩子存在 l <= Heap_size 防止下标越界。
如果不找最大子节点交换,交换后较小子节点成为较大子节点的新-父节点,继续违反 maxHeap。
根据堆的高度性质,这个错误点最多下沉 h=⌊log2N⌋ 层,因此 O(log N)。
void maxHeapify(int data[], int n, int idx)
{
    int l = 2 * idx;
    int r = 2 * idx + 1;
    int smallest = idx;
    // 检查左孩子是否存在
    if (l <= n && data[l] < data[smallest]) smallest = l;
    // 检查右孩子是否存在
    if (r <= n && data[r] < data[smallest]) smallest = r;
    // 已经满足 min-heap property
    if (smallest == idx) return;
    // 交换
    int temp = data[idx];
    data[idx] = data[smallest];
    data[smallest] = temp;
    // 继续向下修复
    maxHeapify(data, n, smallest);
}
其中两个判断中的 && 符合短路写法,l / r 不存在直接 False
⚠️ 该算法前提条件是错误节点的两个子树已经堆!
BMH (BuildMaxHeap)
线性建堆:把数组按层序直接放入堆数组,然后从最后一个非叶子开始做 MaxHeapify(),总共 O(N)
// n == length(arr)
void BuildMaxHeap(int arr[], int n) {
    // 从最后一个非叶节点开始,逆序 siftDown
    for (int i = n / 2; i >= 1; --i)
        maxHeapify(arr, n, i);
}
⚠️ 关键在于 i = n/2。arr[⌊n/2⌋+1, …, n] 全部都是叶,叶没有子节点来违反堆性质——因为一个点 i 有子节点等价于 i ≤ n/2,所以 n/2 正是最后一个非叶节点。从这个节点开始,按逆数组序 (从下往上、从右往左) 对每个非叶子做 maxHeapify,就能保证所有点的子树先满足堆,再把它自己下滤到正确位置,最终全树成堆。
渐进时间复杂度 O(N):底层节点很多,但它们下滤的高度很小;高度大的节点很少。把所有节点下滤的“最大可能移动距离”加起来是线性级。以下是详细思路——
Complexity of BMH (D&C proven)
直觉来说,数组有 n/2 = O(n) 个 internal nodes (非叶节点),每次 maxHeapify() 最差 O(logn),那么BMH 的上界可以简单算得:O(nlogn)。
但这不是 **tight upper-bound **—— 并不是每一个节点的 maxHeapify() 都最差移动 log n 层。
如果从分治角度看,BMH‘(i) 即“将 i 为根建堆”问题可以二分为: BMH’(i/2) 和 BMH’(i/2 + 1);以及最后修复自: maxHeapify(i)。其中每个节点自身开销就是 maxHeapify(i) ≤ ⌊log2N⌋,所以——
T(n) = 2T(n/2) + O(logn)
根据 Master Thm.:a=b=2,L(n)=nlog22=n » f(n)=O(logn),属于叶主导,即 T(n) = Θ(L(n)) = Θ(n)
直观理解:
高度 0 的叶节点:约 n/2 个,每个成本 0
高度 1:约 n/4 个,每个最多成本 1
高度 2:约 n/8 个,每个最多成本 2
……
高度 h:约 n/2h+1 个,每个最多成本 ⌊log2N⌋ $$ Thus\ T(n)=\sum_{h=0}^{\log n}{{n}\over{2^{h+1}}}\cdot h = {n\over 2} \sum_{h=0}^{\log n}{{h}\over{2^h}} $$
$$ Since\ \sum_{h=0}^{\infty}{{h}\over{2^h}}=2,\ T(n)<{n\over 2}\cdot 2 = n \rightarrow Θ(n) $$
HeapSort
比较排序中最朴素的 selection sort 的思路:找当前最大值、放到最后、缩小范围……循环。基线情况找 n 次 max in n elements 需要 Θ(n)。但将数组作为 Heap 结构可以快速找到最大/小值——整个数组的根就是!
-
BMH(arr) 建堆:O(n)
-
找最大值 (arr[1]):O(1)
-
交换 arr[n] 和 arr[1] 将最大值移到数组末:O(1)
-
heap_size--缩小堆宽,将最大值移除堆区域 (还在数组中):O(1) -
新根可能违反堆性质,但子树都还是堆. maxHeapify(arr, n, 1):O(logn)
-
跳转第二步,循环 n 次
统共 O(nlogn),最后堆消失,数组升序 (ascending)。
Priority Queue Operations
Increase Key (增加某项值):
- siftUp 上滤: 当 idx>0 不是根且当前元素“比父亲更大,违反 maxHeap 性质”,交换父子两个元素,递归
- 复杂度 O(log n):最多上升树高 h = ⌊log2n⌋。
Insert (插值):
- 插入新节点必须保持 complete binary tree,所以只能先放到 arr[heap_size +1]
- 可以等价想象为先将 key 设为 -∞,然后做 Increase Key,因此也是 O(logn)
Extract Max (拿掉最大值)
- 等价于将 arr[n] 与 arr[1] 交换然后 heap_size–,maxHeapify(arr, n, 1)
- 与 HeapSort 大体思路 (2~5) 完全一致,故也是 O(logn)
III. Data Structures
A data structure is a collection of algorithms for storing and retrieving information.
数据结构是一系列负责存储和读取数据的算法。
对于有序数组来说,支持的读取和储存 (改变)数据的命令:
-
Queries: MIN(), MAX(), SEARCH(x).
-
Updates: INSERT(x), DELETE(x).
ADT is a class of objects whose logical behavior is defined by a set of values and a set of operations.
抽象数据结构是一组对象以及存储它们时存在的一定特性和功能,但不规定你用什么数据结构实现。
比如栈需要支持 push/pop/peek 并满足 LIFO,但可实现可以是数组栈/链表栈…
Priority Queue 是 ADT;Heap 是实现它的一种数据类型。
Runway Scheduling Problem
我们构造一个 Heap 不够用的场景。假设机场只有一条 runway,降落需要预约。
我们维护所有未来降落时间的集合:R = {t1,t2,… ,tn}。
-
Update:现在一航班想在 t 时间降落,若机场记录中存在某降落时间与 t 相差小于 3 分钟,就不接受。
也就是说,新时间 t 合法 IFF ∄ r ∈ R:|t - r|< 3。
-
Query+Update:同时还要跟踪下一驾降落航班,在其降落后从集合移除。
堆中找 min(R) 很简单,但 update 需要看前项 predecessor(t) 和后项 successor(t)。
Naive Implement: Sorted List
Python list 遍历检查 O(n),插入 O(n logn)~O(n) 取决于排序算法;land = O(n)。
R = []
def insert(t):
    if t < now:
        return error
    for each R[i]:
        if abs(t - R[i]) < 3:
            return error
    R.append(t)
    R = sorted(R)
def land():
    t = R[0]
    if t != now:
        return error
    R.pop(0)
    # 使用 R=R[1:] 复制 0 以外的元素
Sorted Linked List
有序链表没有 随机访问 random access,所以从表头遍历到前后项需要 O(n),插入无需重排只需要改指针 O(1)。
class Node:
    def __init__(self, data, next=None):
        self.data = data
        self.next = next
class List:
    def insert(self, data, p):
        if abs(data - p.data) < 3:
            return False    # 检查与前一个预约的间隔
        if p.next is not None and abs(p.next.data - data) < 3:
            return False    # 检查与后一个预约的间隔
        newNode = Node(data, p.next)
        p.next = newNode
        return True
Sorted Array
有序数组可以用 binary search,最快 O(logn),但动态数组插入需要把后方所有元素往后移一位 O(n)。
Heap
我们讨论过堆的插入是 O(logn),但堆只有父子有序,没法快速找到前后项,可能不得不遍历大量节点 O(n)。
BST
所以我们的需求是:完全有序才能快速找到前后项;但不能像有序数组那样插入 O(n);
二叉搜索树的中序遍历是升序的(左根右);高度 O(logn) 所以插入搜索等都可以 O(logn)。
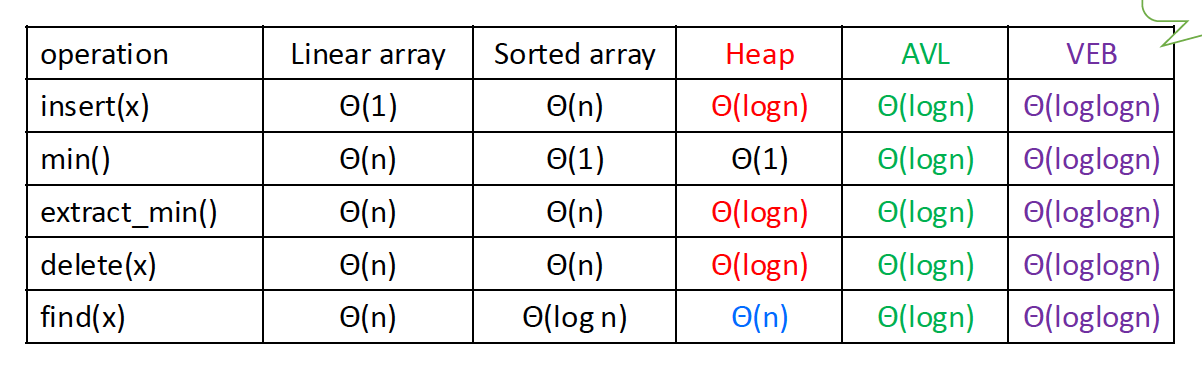
Different applications impose different requirements.
Different data structures change the efficiency of operations.
Usually there are trade-offs; prioritize the most frequent operations.
设计/选择 ADT 的时候一般都有 trade-off,没有绝对好坏,取决于频繁执行哪些操作。比如 Heap 主要关心 extreme value min/max;而 BST 关心整个 key ordering,从而支持 search/pred/succ。
IV. Modular Arithmetic
模的定义
x mod N 运算有两种理解:
- 一个整数 (余数):x = qN + r (0 ≤ r < N) ⇔ x mod N = r
- 无数与 x 同余的整数的集合:y ≡ x mod N ⇔ N | (y-x) ⇔ y = x + kN,等价于 “被 n 除后的余数相同”
mod N 本质上是把无限多个整数 Z 压缩成 N 个余数类:0, 1, …, N-1
Congurence (同余)
-
“mod” (余数) 与“≡” (同余) 的关系:a ≡ b mod n ⇔ a mod n = b mod n
-
同余的加减乘-相容性:若 a ≡(mod n) c、b ≡(mod n) d,则:a+b ≡(mod n) c+d 与 ab ≡(mod n) cd 一定成立
证明思路:代回 a=c+nx, b=d+ny 后整理,说明 n | (a+b-c-d) 或 n | (ab-cd)
即,在加减乘过程中,可以把一个数字换成与它同余的、更小的数字——substitution rule
E.g.: 时间问题 (模-24):Binge-watching BBC’s Sherlock
- 4(seasons) x 3(episodes) x 90(min) mod 24 = 4 x -6 x 3 mod 24 = 0
⚠️ 模运算的中间结果随时可以 mod 缩小问题:𝑥+𝑦 𝑚𝑜𝑑 𝑁 ≡ (𝑥 𝑚𝑜𝑑 𝑁) + (𝑦 𝑚𝑜𝑑 𝑁) 𝑚𝑜𝑑 𝑁;𝑥⋅𝑦 𝑚𝑜𝑑 𝑁 ≡ (𝑥 𝑚𝑜𝑑 𝑁)⋅(𝑦 𝑚𝑜𝑑 𝑁) 𝑚𝑜𝑑 𝑁
- 2345 ≡ (25)69 ≡ 3269 ≡ 169 ≡ 1 (mod 31)
- 67321637 + 73747728 mod 10 ≡ 7+8 mod 10 ≡ 5
Bit complexity of mod
对于 n-bit 的 x, y, N,x ⊕ y mod N 的渐进时间复杂度为:
- +, - O(n);x O(n2);÷ O(n3)
模运算
普通乘法
递归 T(n, n) = T(n, n−1) + O(n) = … = T(n, 1) + (n-1)O(n) ⇒ O(n2)
普通除法
def divide(x, y):
    if x == 0: return (0, 0)  # 整除
    q, r = divide(x // 2, y)
    q = 2 * q
    r = 2 * r
    if x % 2 == 1: r += 1  # 奇数x
    if r >= y:  # 余数>除数:回溯一次并终止
        r -= y
        q += 1
    return (q, r)
以上函数得到 x = qy + r (0 ≤ r < y)
先把 x 除以 2,把规模缩小;然后从 ⌊x/2⌋ 的答案恢复 x 的答案。
复杂度同样 O(n2)
模乘法
xy mod N ≡ z mod N (z = xy),显然 O(n2)
模除法
考虑 x/y = xy-1 mod N,令 zy ≡mod N 1 (z 是 y 的乘法逆元 (multiplicative inverse))
-
定义:在模 n 下,a 的逆元 a’ 满足 aa’ ≡ 1 (mod n)。讨论时一切元与逆元都小于模 n。 比如 3 的 “模 10 逆元” 是 7 —— 21 ≡ 1 (mod 10)
-
逆元存在的充要条件:被模数与模互质 (gcd(a, n) = 1) ⇔ 逆元存在。证明用 Bézout:gcd(a, n) = sa+tn = 1,则 s 就是 a 的逆元 (mod n)。 比如 2‘ (mod 10) 是不存在的,因为 gcd(2, 10) = 2。
显然,被模数 a ≠ 0
可以用 Extended Euclidean Algorithm 找 inverse,复杂度为 O(n3)。
使用例 1:gcd(728,476) = gcd(476,252) = gcd(252,224) = gcd(224,28) = gcd(28,0) = 28(没有乘法逆元)
28 = 252−224 = 252−(476−252) = 2⋅252−476 = 2(728−476)−476 = 2⋅728 − 3⋅476(EEA)
使用例 2:
EEA 反推 Inverse:
模指数
如果直接用连乘硬算模指数 xy mod N,相当于 O(2n)。
即使每步都 mod 也不够:((((𝑥𝑚𝑜𝑑𝑁)(𝑥𝑚𝑜𝑑𝑁)𝑚𝑜𝑑𝑁)𝑥𝑚𝑜𝑑𝑁𝑚𝑜𝑑𝑁)𝑥𝑚𝑜𝑑𝑁𝑚𝑜𝑑𝑁)… 这不影响如果 y 很大,还是很慢
比如 313 ≡mod 7 3(36)2 ≡mod 7 3((33)2)2 ≡mod 7 3((3(31)2)2)2 ≡mod 7 3(1)2 ≡mod 7 3
T(n) = T(n-1) + Θ(n2),只需要 O(n3)
CSC4120 W04 Augmented BSTs
I. 平衡二叉搜索树:AVL
回顾
- height:从这个节点到其子树最深叶有多少边,树高就是 height(root),叶高都是 0。
- depth:从根到这个节点有多少边。
BST 满足每个节点 X 的左子树节点 < X;右子树 > X;且左右子树本身也都是 BST。
其效率和插入时的无序性正相关,平均情况下,树的高度 ≈ ⌈log2(n+1)-1⌉:查找/插入/删除平均 O(log N)。
但是,例如按“升序”插入,每次新节点都会变成“上一节点的右孩子”,整棵树退化成单链表,平均复杂度 O(N)。这就是为什么需要平衡二叉树 (AVL、红黑树) 的原因。
Augmenting BSTs
扩充二叉搜索树:在普通 BST 每个 node 上额外存一点 metadata
普通 node 原本可能只有 key、left、right;扩充 BST 比如多存一个 size 记录其子树总点数。
Runway Scheduling Problem Again …
若想知道有多少飞机降落时间不晚于 t,O(n) 遍历 BST 当然可以,但是扩增 size() 参数后搜索就 O(logn)——
K = 0
while node != null:
    if t < node.key:
        node = node.left
    else:  # node.key <= t
        K += size(node.left) + 1
        node = node.right
思路:从根往下走,在某点处,若值小于 t,则它与其左树 (size(node.left) + 1) 都符合要求,向右子节点递归。
BST 不仅能 Search;给 node 加 metadata 后,可以支持更多 query。
AVL
平衡二叉树:每个 node 保存各自附近必须满足的某个局部条件 (local invariant relation),通过设计算法维持这个条件确保树高 h = Θ(logn)。
Adelson-Velskii & Landis Tree:每个node 保存自己的高,规定 height(leaf) = 0;height (NIL) = -1,满足条件 |height(left) - height(right)| ≤ 1。
- 为确保可以比较左右树高,我们必须引入“空树”和 NIL(空占位节点)——任意节点若没有左/右子节点就会伸出空占位节点,NIL 没有值,相当于 NULL。
- 任意点左右子树高度差不超过1不代表根到任意叶路径差不超过1!
Proof of Balance
- 上界 (最高情况)
假设根的一侧高 h-1,另一侧最矮 h-2,所以 nh ≥ nh-1 + nn-2 + 1,因为 nh-1 > nh-2,所以 nh » 2nh-2
继续递推:nh > 2nh-2 > 4nh-4 > … > 2h/2nh-h,故 log2nh > h/2 → h < 2log2nh
得证树高属于 O(logN) 数量级,where N 为总节点数。
- 下界 (最矮情况)
对于满二叉树 n ≤ 1 + 2 + 4 + … +2h = 2h+1 - 1,即 h ≥ log2(n+1) -1 → Ω(logn)
综上所述 AVL 的高度满足 h = Θ(logn)
故 AVL 的 search()、delete()、insert() 均为 Θ(logn)。
维护平衡——左右旋
我们把父节点与右子节点交换位置叫左旋,与左子节点交换位置叫右旋: 左旋 L leftRotate(root, root->right):父节点拿走右子节点的左子树 (作为自己的右子树) 并成为右子节点的左子树。这降低父节点的左树、升高子节点的右树。
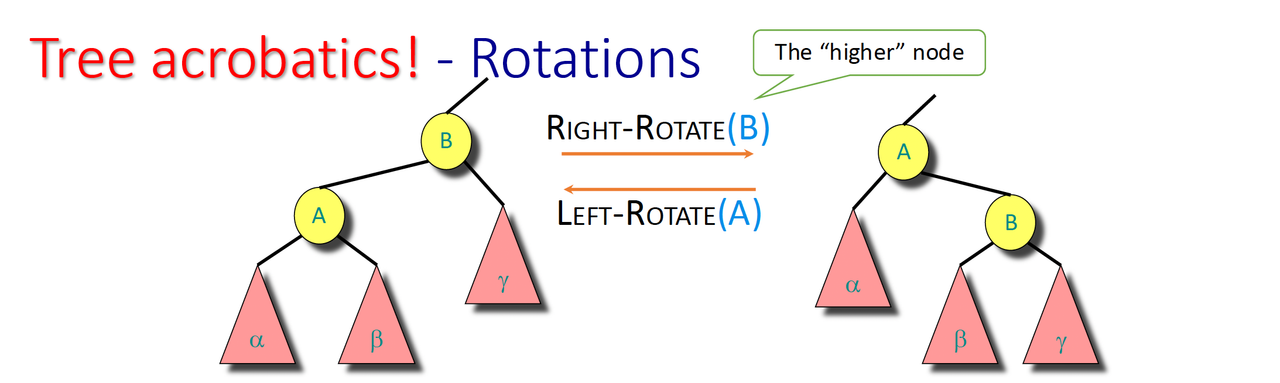
左右旋不会改变 BST 的大小顺序,即旋转后依旧满足中序遍历升序——改变 tree shape 但不改变 sorted order。
AVL 的 Insert() 等同于 BST 的插入函数 + 从插入点往上到根依次更新高度参数 + 检查是否要重平衡;delete() 同理。
⚠️ 我们以 “某个子树长” 为标准,一共有四种不平衡可能 (假设 x 为发现不平衡的节点)
-
左子节点的左子树长:LL-heavy,右单旋 x
或 左子节点过高但其子树平衡,L-balanced,右单旋 x
-
右子节点的右子树长:RR-heavy,左单旋 x
或 右子节点过高但其子树平衡:R-balanced,左单旋 x
-
左子节点的右子树长:LR-heavy,左-右双旋 (左旋 x.left 后右旋 x)
-
右子节点的左子树长:RL-heavy,右-左双旋 (右旋 x.right 后左旋 x)
(双旋第一步先旋“较高的那个子节点”,第二步再旋失衡节点 x。)
⚠️ 1、2 情况失衡方向是直线型 (顺式单旋);3、4 情况失衡方向是折线型 (反式双旋)
所谓失衡方向就是失衡位置往下找过长路径时两次找子节点的方向
对 insertion 来说,修好最低 violation 后,这棵 subtree 的高度通常恢复成 insertion 之前的高度,因此这个“高度增长”不会再继续向上传播。
E.g.: 情况 3 ——
         x                  x                x.l.r
  (往右)/  \     左旋       /  \    右旋      /     \
     x.l    B    ->     x.l.r  B    ->    x.l      x
    /   \(往左)         /    \            /  \     / \
   A    x.l.r         x.l     D         A    C   D    B
       /    \        /   \
      C      D     A      C
Example of Rotation
        10
       /  \
      8    16
          /  \
         15   18
        /
      14
从叶子向上检查左右子树高的差:14 (-1 : -1) 没问题、15 (0 : -1) 没问题、16 (1 : 0) 没问题、10 (0 : 2) 违反 AVL,故将 10 作为不平衡点 x。
x 的失衡方向显然是 RL-heavy (右子节点的左子树),需右旋 16,然后左旋 10
        10                    15
       /  \                  /  \
      8    15              10    16
->        /  \      ->    /  \     \
        14    16         8    14    18
                \
                 18
II. Interval Trees
区间树,类似于 AVL 和 红黑树,也是一种扩充 BST,用于处理区间冲突问题 (如机场航班,课程安排…)
Query:对于 区间 i,找树中 overlap 的区间。overlap (重叠):两个区间 [a,b]、[c,d] 不重叠 IFF b < c OR d < a
如果使用普通 BST,保存区间 [low, high],可以按 low 升序,但不确定从根出发向哪侧找。E.g. 找 [42, 50],根是 [30, 35],不能仅根据区间左侧值大小向右子树递归,不排除左子树可能有长区间,例如 [10, 10000]。
区间树的构造
仍按 low 升序排 BST,但每个节点额外保存其子树 (包括自身) key 中出现的最大值 (肯定是某个节点的 high 值)—— m[x] = max{high[x], m[left[x]], m[right[x]]}
E.g.          [17,19] m=23
             /           \
      [5,11] m=18       [22,23] m=23
        /      \
 [4,8] m=8   [15,18] m=18
              /
        [7,10] m=10
区间树使用 红黑树 为基础,h ≤ 2log2(N+1)(⚠️ 所有平衡 BST 必然满足 h = O(logn))。的 insert() 和 delete() 只影响到根的路径上的点,所以复杂度依然是树高级别,即 O(logn)。
这样处于任意节点都可知左右子树有无可能存在 overlap:
search(x):
    x = root
    while x != NIL and (low[i] > high[int[x]] or low[int[x]] > high[i]):
        if left[x] != NIL and low[I] <= m[left[x]]:
           x = left[x]
        else:
            x = right[x]
    return x
- ⚠️ 为什么用“往左”主导不会错?
-
如果算法决定往右,必有
low[x] > m[left],左侧所有区间闭合点小于 x 区间张开点,左侧必不存在重合 -
如果算法决定往左,必有
low[x] ≤ m[left],表示左边可能重合,但左边没重合时右边有重合是不可能的!已知左子树最大区间 i 的 high[i] ≥ low[x],且不重合,low[x] 必然至少比 low[i] 小,否则 x 与 i 重合。即,x 被 i 区间 bounded above (向下包围),既然右子树的 low 都大于左子树的,右子树不可能有重合。QED
既然 search() 每次递归只走左右子树的一侧,最差情况遍历树高各节点,也是 O(logn)。
III. VEB Trees
Van Emde Boas Trees 的目的是使用分治打破平衡二叉树各项操作 O(log n) 的下限。
当 key 来自一个有限整数集 universe: U = {0, 1, …, u-1} 时,把 Insert / Delete / Successor / Predecessor 做到 O(log log u)(u = 可能的 key 数量,n = 实际存的 key 数量)
具体要求:对于二叉搜索 T(k) = T(k/2) + O(1) = O(log k),将 k = log u,那么 T(log u) = T(${log u} \over 2$) + O(1) = T(log √u) + O(1) = O(log log u);定义 T*(u) = T(log u) = T*(log √u) + O(1) = T*(log log u)
所以我们需要每次递归缩小问题到原本的二次根
Bitset
对于 |U| = u,建立一个类似于 std::bitset 的二进制动态数组 (bit vector),每一位 1/0 有序对应 U 中各个元素存在与否:
- 比如 {1, 2, 4, 7} ≡ [0, 1, 1, 0 ,1, 0, 0, 1, …]
Insert()/Delete():直接检查 BitVector[] 的 index,O(1)Predecessor()/Successor():找更比输入值更小/更大的元素,最坏遍历 U,O(u)
Universe u → Clusters √u
既然找更大/小元素遍历项的 worst case 较差,我们适时的将 U 切成 √u 个 长度为 √u 的 clusters (簇)
- Callback:每次递归缩小问题到原本的二次根
E.g.: {1, 9, 10, 15}
             cluster[0]   cluster[1]   cluster[2]   cluster[3]
positions       0–3         4–7         8–11        12–15
bits            0100        0000        0110        0001
summary          1           0           1           1
其中,summary 数组记录哪个簇存在元素 (非空):summary[i] = 1 IFF cluster[i] ≠ ∅ ——从而便于检查
V.summary 自己也是同一种数据结构—— universe size 为 √u 的同类型结构。这就是 recursion 出现的地方。
summary 中,任意元素可由 x = i · √u + j 索引,其中 x 在第 i 个簇的第 j 位置;或者表示为 √u 位二进制的 ij。
-
⚠️ 更具体的,i = high(x) = ⌊x / √u⌋,j = x mod √u,x = index(i, j) = i · √u + j
这是显然的,相当于 x 被按序映射进宽为 √u 的桶中,使用 (商, 余) 定位 x。
-
比如上述 16 元 vector 中的 9 可以表示为 2 x 4 + 1,或 9DEC = 1001BIN
1001BIN = 10 (high) | 01 (low) —— ⚠️ 将 x 的二进制表达从正中间“劈开”就可以得到 i 和 j
对于足够大的 U,每次递归创建 sub-cluster 和对应 summary,将问题缩小到 √u ——
T(u) = T(√u) +O(1)
假设 u → u1/2 → u1/4 → … → Θ(1) 共需 k 次递归:u1/2k ≈ 2,with logarithm:(log2u) / 2k ≈ 1 → 2k ≈ log2u → k = O(log2log2u)
Successor() Complexity in VEB
直觉来讲,找 x 的下一个更大项可以分为 3 个 O(√u) 操作:
-
在 x 所处簇中找更大值,wcc 遍历 cluster[high(x)] —— O(√u)
-
若没有,从 summary[high(x)] 开始索引下一个非 0 项,记作 i。最差遍历 √u 个簇 —— O(√u)
-
按序遍历 cluster[i],对第一个找到的 y = 1 返回 j = low(y)。最差遍历 cluster[i] —— O(√u)
返回 index(i, j)
统共 O(√u) 量级,明显优于朴素解法 (普通 BitVector) 的 O(u)。
Problems with Insert()
现在,因为我们在每层递归维护了两个平行数据结构 (summary & cluster),Insert(V, x) 需要做 2 次:
Insert(V.cluster[high(x)], low(x))
Insert(V.summary, high(x))
于是:T(u) = 2T(√u)+O(1) = O(log u),退回到 AVL 基线,故不能有 2 个递归操作。