💻 CSC4120 Week 1 渐进复杂度与分治的推论与运用
Lithos
CSC4120 W01 引入:复杂度与分治
I. Asymptotic Complexity
增长率
我们先定义函数 T(n) 表示算法处理一个大小为 n 的输入时,最差需要多少“基本操作”。
算法分析的目标不是问:“我的 MacBook 跑这个程序用了多少毫秒?”,而是问:当输入规模 n 增大时,所需要的工作量怎样增长?
这就是 algorithmic complexity(渐进复杂度) 的基本思想——我们不关心算法的某一精确运行时间
比如在比较保守的 worst-case complexity(最坏情况复杂度)下,遍历算法的 wcc 就是 $T(n)\propto n$。
$n \rightarrow \infty$ 时,只保留 T(n) 的 增长率(rate of growth),忽略:multiplicative constants(常数倍)、lower-order terms(低阶项),比如 $T(n)=3n^2+100n+5000 = \Theta(n^2)$。这就是所谓的 dominant term(主导项)。
故计算机型号、 CPU、compiler optimization 等具体因素就不再重要——它们作为常系数,在渐进复杂度角度下会被主导项压过——我们只关心增长率数量级。
复杂度符号
| 符号 | 意思 | 直观理解 |
|---|---|---|
| O(g(n)) | Upper bound(Ceil) | f(n) 最快不超过 g(n) 增长率 |
| Ω(g(n)) | Lower bound(Floor) | f(n) 最慢不低于 g(n) 增长率 |
| Θ(g(n)) | Tight bound | f(n) 增长数量级等于 g(n) |
将目标函数设作 f(n),那么三个符号分别严格定义为:
-
从某个足够大的 n 开始,f(n) 永远不会比 g(n) 快超过一个常数 c 倍。例如 $n=O(2^n)$ 成立,一个 O(n) 的算法当然也是 O(n^2)。
-
从某个足够大的 n 开始,f(n) 永远不会比 g(n) 慢超过一个常数 c 倍。例如 $n^2=\Omega(n)$ 成立。
-
从某个足够大的 n 开始,c1g(n) ≤ f(n) ≤ c2g(n)。我们可将 $\Theta(g(n))$ 理解为一系列与 g(n) 同渐进复杂度 (增长率同数量级) 的函数
如果一个函数在 $\Theta(n^{1.5})$ 和 $\Theta(n^2)$ 之间不断震荡,它不一定能够写成某一个简单的复杂度。故复杂度不只是简单的“删系数留主导”,标准定义很重要。
-
对于:a,b>1 k,r>0 有:$\lim_{n\to\infty}\frac{n^r}{a^n}=0$
意思是:任何多项式最终都比指数函数增长得慢。
即:n100=O(1.01n),即使 1.01^n 看起来增长非常慢。
-
类似的:$\lim_{n \to \infty} {{(log_b n)^k}\over{n^r}}=0$
即:任何固定次幂的对数都比任何正次数的多项式慢。
$(logn)^k \ll n^r \ll a^n$
好算法远比好硬件重要
$$1<log_c n<n<nlog_c n <n^2<n^3< … <2^n$$
- $\Theta(\log n)$:GREAT
- $\Theta(n)$:GOOD
- $\Theta(n^2),\Theta(n^3)$:开始昂贵
- $\Theta(2^n)$:BAD
一台普通机器 A 和一台大约 快 107 倍 的机器 B。即使硬件性能提升一千万倍,指数算法 2n 在输入稍大时仍然荒谬地慢,因为每增加一个输入就计算量翻倍——好的算法通常比好的硬件重要得多。
证明(算法)复杂度
证明 $T(n)=\Theta(f(n)) $,即证明 $\forall n: T(n)=O(f(n)) \ AND \ \exists n T(n)=\Omega(f(n))$ ——无论输入是什么,都不会比 f(n) 更糟,且存在一个 worst-case input,让算法至少做这么多工作。
因为课程定义:T(n)= max running time,即 worst case,所以上界要证明全部,下界只要证明存在一个 worst case。
⚠️ 算法复杂度和问题复杂度不同;前者兜底算法的最差表现,而后者证明对于此问题“存在这么快的算法”(存在上界) 以及“任何算法都不可能更快” (全部符合下界)。比如说 MergeSort=O(nlog n) 是在讨论某个算法的复杂度。但是说:sorting requires $\Theta(n\log n)$ 则是在讨论这个问题本身有多难。
II. D&C, Master Thm.
Divide and Conquer
分治 (D&C) 表示把一个规模 n 的问题拆成若干更小的同类问题递归解决,再合并:T(n) = divide_time(n) + $\sum_iT(n_i)$ + combine_time(n)。
InsertionSort
比如 InsersionSort(n):依次加入原始项并在新数列中将其前移直到前项小于此项。证明:
任意 n 有 𝑇(𝑛)=𝑂(𝑛2):相当于把排序分成了 n 次最差要移动 n 次的子任务
存在 n 使 𝑇(𝑛)=Ω(𝑛2):最坏就是倒序:[n,n-1, … ,2,1],第 i 个元素大概要移动 i 次,总次数:
1+2+3+ … +(n-1) = order of n2
MergeSort 与树递归
D&C 的另一个典型运用是“二分法”,如 MergeSort(n):$$T(n) = 2T({n\over 2})+\Theta (n) = \Theta (nlogn)$$
其中 $\Theta(n)$ 来源于 divide & combine 的线性时间,并被主导项掩盖。Merge Sort 每一层总工作量都是 cn,树高约为 log n,因为我们计算的是普通串行算法,不存在并行运算,因此复杂度为 nlogn 级。
几何级数
回忆几何级数 (Geometric Sum):S=1+x+x2+ … +xh。当 x ≠ 1,$S={{x^{h+1}-1}\over{x-1}}$
-
当 x < 1,总和趋向一个常数∈ $[ 1, {1\over {1-x}} ]$,S = Θ(1)(第一项主导:Θ of the first term)
-
当 x > 1,总和趋向最后一项,S = Θ(xh)(最后项主导:Θ of the last term)
-
当 x = 1,总和为 h,S = Θ(h)
几何级数告诉我们在一个递归式中哪项主导结果,类似的,一个二叉树中叶和非叶节点成本谁主导总成本。
递归树 (recursion tree)
如果每次分为 b 份,n → b 个 n/b → bk 个 n/bk,直到 n/bk=1 时 不可再分,即 递归深度k = logbn
对于一个 a-叉树,对于深度 k 处,节点个数为 ak = nlogba(利用恒等式 $x^{log_a y}=y^{log_a x}$)
用 D&C 证明 MergeSort 复杂度
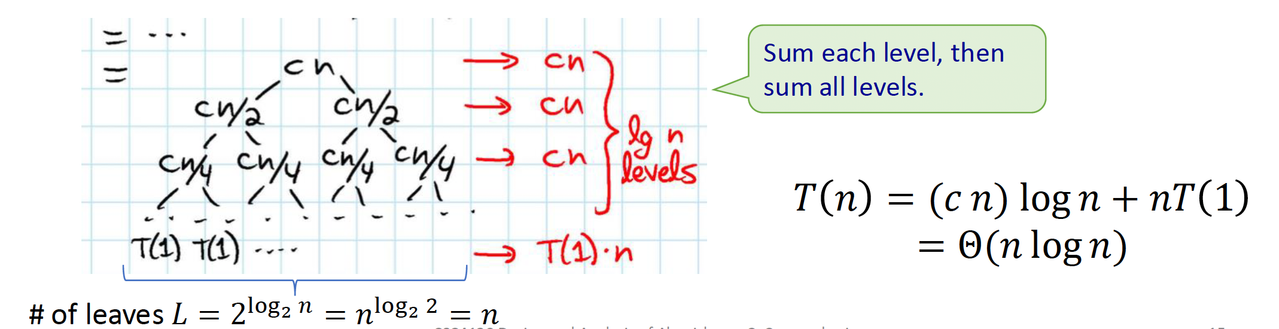
T(n) = 2T(n/2) +cn
-
非叶节点:根节点 (二分 n 个对象) 的成本为 cn,第 k 层的二分任务成本为 2k-1·cn/2k-1 = cn。每层 cost 相等,相当于几何级数 x=1 情况。共 log2n 层,故二分总成本为 cnlog2n = Θ(nlogn);
-
叶节点:不可二分的最深层每个叶节点的成本为 base-case T(1)=Θ(1),有 nlog22 = n 个叶,则叶成本为 Θ(n)
(记 𝐿= # of leaves = 𝑎log𝑏𝑛=𝑛log𝑏𝑎 )
显然的,这里非叶节点即二分过程主导了结果的复杂度:Θ(nlogn)+Θ(n)=Θ(nlogn)
用数学归纳法(Induction)证明
猜 T(n) = O(nlogn),即证明存在 c1 使 T(n) ≤ c1nlogn。
假设对 x<n,T(x) ≤ c1xlogx 成立,代入 T(n) = 2T(n/2)+cn,于是 T(n) ≤ 2c1(n/2)log(n/2)+cn = c1nlogn - c1n + cn。
那么只要 c1 ≥ c,就满足 T(n) ≤ c1nlogn,QED。
整个过程以猜代证是,故又称 substitution method
Master Theorem
MergeSort 是一种每层非叶节点成本均为 cn 的平衡情况,递归不一定如此:
-
比如 T(n) = T(n/4) + T(n/2) + n2,根节点成本为 n2,下一层为 (n/4)2 + (n/2)2 = 5n/16……以此类推,总成本为 $n^2[1+{5\over{16}}+({5\over{16}})^2+…]$,根据几何级数推论 (5/16 < 1),总成本为第一项(根)主导:n2Θ(1) = Θ(n2)。
-
反过来,T(n) = 4T(n/2)+n 的节点增长率 (x) 为 2>1,故总成本为最后项(叶)主导:Θ(xh) = Θ(4log2n) = Θ(n2)。
以此,我们已经推导出 Master Thm. 的三种情况,即几何级数的三种 x:
将递归树通式记作: T(n) = aT(n/b) + f(n),其中每个问题产生 a 个子问题、每个子问题缩小 b 倍、当前问题节点本身成本为 f(n)。
对于 f(n) = nk,总成本为:$n^k[1+{{a}\over{b^k}}+({{a}\over{b^k}})^2+…]$,如果定义 s = a/bk,T(n) 就可明显看出一个几何级数——
- 当 a/bk < 1,根主导,成本逐层变小,T(n) = Θ(nk)
- 当 a/bk = 1,每层成本一样,T(n) = Θ(nklog n)
- 当 a/bk > 1,叶主导,成本逐层变大,T(n) = Θ(L) = Θ(nlogba)
更普遍的,对于 T(n) = aT(n/b) + f(n),永远应首先对比根与叶:L(n)=nlogba 和 f(n)——
-
叶主导,即 f(n) = 𝑂(L1−𝜖) 根至少比叶低一次幂:T(n) = Θ(L)
-
同数量级:f(n) = Θ(nlogba) ⟹ T(n) = logbn·f(n) = Θ(nlogba · log n)
log-factor 延伸(数量级相差为对数):f(n) = Θ(L·logn) ⟹ 𝑇(n) = Θ(L·log2𝑛)
-
根主导,即 f(n)=Ω(L1+𝜖) 根至少比叶高一次幂;且 af(n/b) ≤ sf(n), s<1 层成本递减:T(n) = Θ(f(n))
比如 T(n) = 9T(n/3) + n 就是叶主导,T(n)=2T(n/3)+log2n+n 就是根主导。
III. Peak Finding Problem (PFP)
PF in 1D
在一维离散有序结构 (数组) 中,峰代表不小于前后元素的点 (Local Maxima)。对于 PF 问题 (找到任意一个峰),最直观的方法是按序遍历并比对前后项直到满足。wcc 情况下,对于严格升序数组,T(n) = Θ(n)。
如果我们运用 D&C,从数组中间m= (\lfloor n/2 \rfloor) 开始,存在三种情况,A[m-1]>A[m],向左递归;A[m+1]>A[m],向右继递归;否则 A[m-1] ≤ A[m] ≥ A[m+1],A[m] 就是峰。
根据 Master Thm.,二分 b=2,单向递归 a=1,每层的比较是常数次的:T(n) = T(n/2) + O(1),k=0,s=1,平衡情况,故 T(n) = Θ(n0log n) = Θ(log n)。
对于 D&C 问题,递归到一个子问题时,要保证两件事情:
a)子问题里面确实存在原问题的 peak;
b)子问题的边界不能凭空制造一个假的 peak。
⚠️ 递归子问题中的 peak,不一定自动是原问题中的 peak
1D 算法里,我们选择搜索方向的方法恰好保证了这个问题不会破坏答案。但是到了 2D 就要注意。
PF in 2D
在二维离散有序结构 (矩阵) 中,峰需要不小于四个相邻元素。有两种方法:1、从某点出发往周围四点最大点方向递归;2、遍历矩阵——两者均为 T(n) = Θ(n2)
如果先找到每列最大值,再将所有列最大值组成一个行数组,对其做 1D D&C。但是 T(n) = nΘ(n) + Θ(logn) = Θ(n2),并没有数量级提升。
但是 D&C 不需要所有列的最大值,如果先计算中心列和其相邻列,然后分三种情况递归,只需要查看 O(logn) 数量级的列,故 T(n) = logn·Θ(n) = Θ(nlogn)
What if I want Linear Complexity?
如果要线性复杂性算法,必须 s<1, k=1(根主导),即 T(n) = T(n/2)+O(n) (假设 b=2,a 不能是非正整数,只能为 1)。所以要每次检查 O(n) 个点然后递归缩小问题到 1/2。
有一种想法 (左下图) 是在矩阵上画一个十字,并在十字范围内的 O(n) 个点遍历最大值,然后判断最大值不在十字上的两个相邻位置,若有比它大则取较大者所在四分区域继续递归,反之就是峰。完美……吗?
⚠️ 但这种想法是错误的,会构造出“伪“峰。因为十字区域的点递归后不再考虑,递归的”方形区域“原本靠内的两个边被伪造成边界(相邻点丢失)。子问题的边界不能凭空制造一个假的 peak!
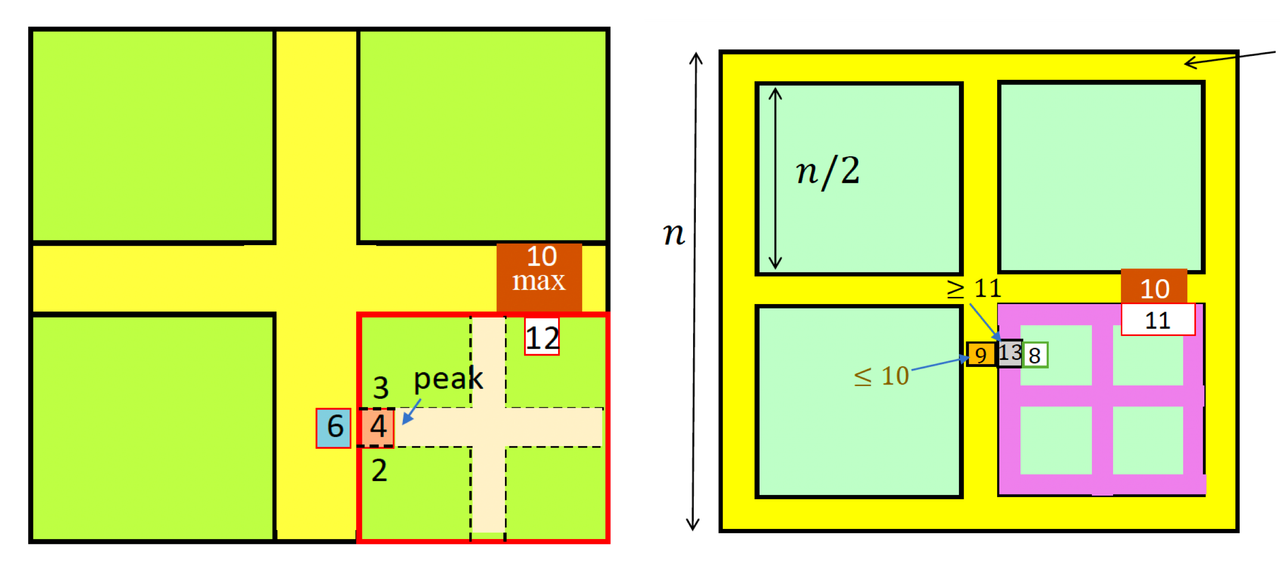
解决方法是每一层改用窗框形区域,这样递归时可以保证子问题找出的最大值≥母问题的最大值+1。反思十字做法,它在递归时没有确保这一点,导致子问题可能丢失母问题的 peak。
证明其复杂度很简单:
- 上界:$T(n) ≤ T({n\over2}) + cn < 2cn$,故 T(n) = O(n)
- 下界:第一次找最大值要遍历 6n 个元素,因此最少需要 Ω(n)
递归不仅确保确实有 peak,还考虑可能碰到由新边界制造的假 peak。