💻 CSC3150 Week 7-8 Schedule Deadlocks & Modern Scheduling
Lithos
(第八周为 in-class 期中考试,时长 90 分钟)
CSC3150 Lecture12 Scheduling: Deadlocks
Real-time scheduling 实时调度
Perdicatability:实时系统的目标不是让任务更快完成,而是可靠地在规定时间内完成。
因此实时系统更关注:Worst-Case Response Time (WCRT)
- Hard Real-Time:必须满足 Deadline (超时可能造成严重系统失败),典型调度策略为 Earliest Deadline First (EDF)。
- Soft Real-Time:尽可能满足,但允许一定的 Deadline Miss,典型算法如 Constant Bandwidth Server (CBS)
Hard Real-Time: EDF
Round Robin 只是公平轮流分配 CPU Quantum,不考虑哪个任务 Deadline 更近;
实时系统需要每次选择已 ready、尚未完成且绝对 Deadline 最早的任务,即 EDF。它属于 Preemptive Scheduling (可抢占) & Dynamic Priority Scheduling (动态优先级),因为任务优先级不固定,由当前 Job 的绝对 Deadline 决定:新到达的任务 deadline 若更早可打断当前任务。
Periodic Tasks 周期任务:Ti = (Pi, Ci) P 代表周期长,C 为所需 CPU 计算时长。那么第 k+1 次 deadline 为 Dik+1 = Dik + Pi。
EDF Feasibility Test:对 n 个任务,必须满足 $\sum_{i=1}^{n}{{C_i}\over{D_i}}≤1$ 才存在调度,否则单核无法完成。
对于周期性任务,利用率 U = $\sum_{i=1}^{n}{{C_i}\over{P_i}}≤1$ 表示 CPU Capacity
Multi-core Scheduling
多核调度在算法上和单核相近,但是:
- 需要 per-core 调度数据结构解决 Cache Coherence
- 任务究竟该被安排在哪个 CPU Core 上?
Affinity (处理器亲和性) Scheduling:OS 尽量让 Thread 回到之前执行过的 CPU Core (缓存有可能存有其数据)
- Cache 复用 (higher hit rate)、Branch Prediction 状态复用、减少不必要的迁移开销;
- 必要时线程可能迁移:为了 Load Balancing,OS 仍可把任务转移到其他核。
Spinlock 在多核系统中有用——
int value = 0;
Acquire() while (test_and_set(&value)) {}
Release() value = 0;
如果 Lock 已经被占用,线程就不断 Busy Waiting 循环检查,T&S 必须原子操作。
⚠️ 因为持锁线程可能正在另个 Core 执行,且很快就会释放。此时忙等一小段时间可能比进入 Kernel 睡眠再被唤醒更快。但是如果等待时间很长,Spinlock 会浪费 CPU。
T&S 导致多个竞争线程 (即使 Lock 一直没有释放) 反复执行写操作,可能造成 Cache Line 在不同 CPU Core 之间反复转移,增加 Cache Coherence Traffic (Cache Ping-Pong)。
解决方法是 Test&Test&Set:先用普通 Read 检查 Lock,仅当锁可能空闲才尝试 T&S
Acquire() {
    do {while (value);}  // 普通读取,等待 lock 可能空闲
    while (test_and_set(&value));
}
T&T&S 避免每次循环都执行昂贵的原子写操作,但锁释放时仍可发生竞争。
Scheduling Evaluation
三种调度算法评价方式:
-
Deterministic Modeling:给定固定 Workload,直接计算算法表现;
-
Queueing Models:通过数学模型分析随机 Workload;
-
Implementation / Simulation:通过实际实现或仿真测试性能。
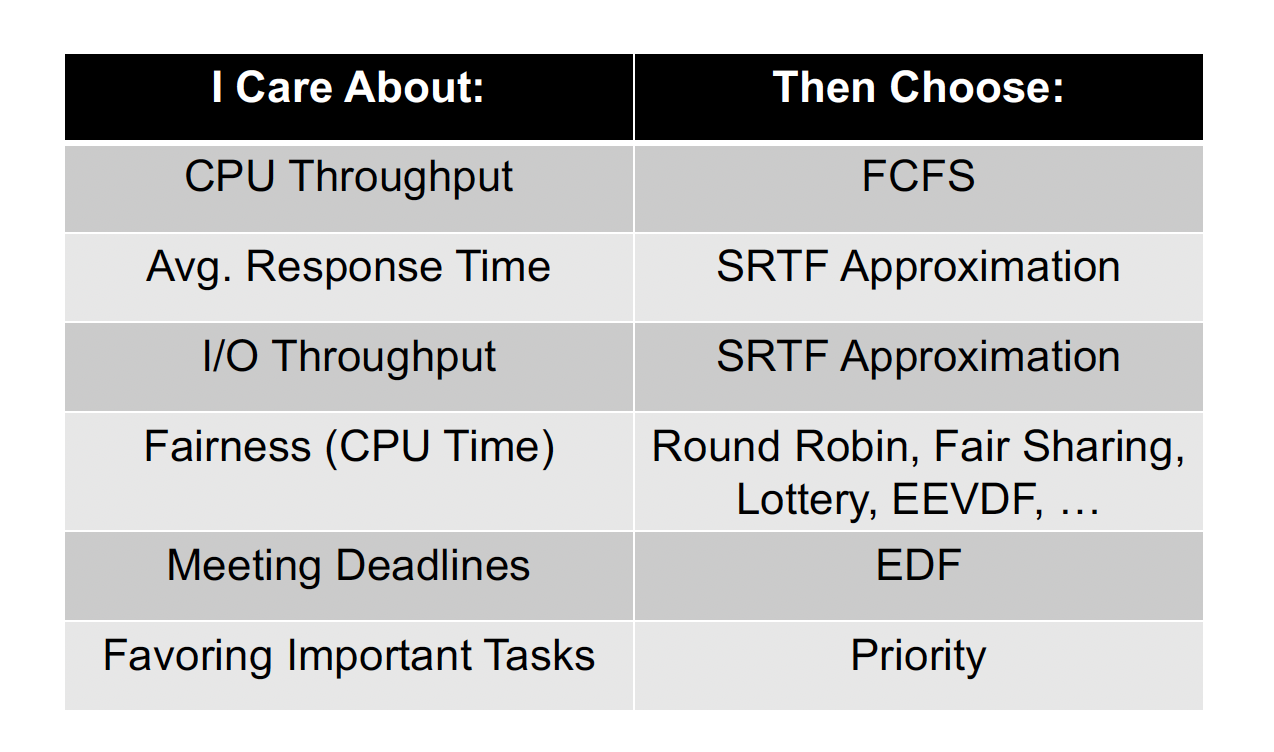
调度规则和公平性在资源不足时尤其重要;
当 Utilization 接近 100% 时,Response Time 陡增 →∞。
原因是系统接近饱和时,即使新任务数量只增加一点,排队等待时间也可能大幅上升。
因此,合理扩容/硬件提速通常不应该等到资源使用率达到 100% 才进行,在 U-R Load 曲线不再平缓时就应进行。
Priority Inversion
Priority Inversion 是严格优先调度的典型困境:存在三个优先级从低到高的任务,A 首先获得 Lock;C 到达并尝试获取 Lock 并 Block;B 也处于 Ready 状态, Scheduler 会优先 B,它无需锁并可以不断运行,间接阻断 C。这就是 B/C 优先级反转。
解决方法是一种 Dynamic Priority —— Priority Donation/Inheritance (优先级继承):让持锁的低优先级任务暂时继承等待锁的高优先级任务的优先级,在释放锁后恢复。
Priority Inheritance 不保证彻底消除所有等待,也不能自动解决 Deadlock,它主要解决的是由于中优先级任务抢占而造成的 Priority Inversion 延迟。
Deadlock Condition&Detection
Starvation 饥饿:thread waits indefinitely,比如优先调度常见低优先级线程长期得不到 CPU 资源。
Deadlock 死锁:circular waiting for resources 循环资源依赖,A 需要等 B 的资源,且 B 需要等 A。Deadlock 是一种特殊的严重 Starvation (Starvation 不是 Deadlock)。前者可能随调度策略变化或高优先级任务完成而结束 (而且不一定是需要结束的负面事件);后者通常无干预永不结束。
类比单道桥,如过东向车流不断,西向车无法上桥就是 Starvation;一辆西向车趁空档上桥,结果两个方向在桥上堵住就是 Deadlock。
Deadlocks When?
Locks、Memory、Printers、Terminals、CD drives… (等独占资源) 和 Pipes / Sockets (等其他线程) 都可能造成 Deadlock。
Lock Deadlock:
 Thread A               Thread B
x.Acquire();           y.Acquire();
y.Acquire();           x.Acquire();
// Critical Section    // Critical Section
y.Release();           x.Release();
x.Release();           y.Release();
non-deterministic deadlock:这里有概率但不必然发生死锁 (更难 debug),取决于线程执行顺序 Interleaving。但不是所有死锁都依赖执行顺序。
- 若 A B 交替获得 x 和 y,两个线程互相依赖,都无法运行到
Release(); - 反之某一线程同时获得 x 和 y,就不会死锁。
其他例子比如 Memory Deadlock:有限内存下连续 Allocate 可能引起类似死锁。
Conditions of Deadlocks
死锁可能发生必须同时满足的四个必要条件 (Coffman Conditions):
-
Mutual Exclusion 互斥:同一个资源在同一时刻只能被一个线程使用。
-
Hold and Wait 持有并等待:线程已经持有至少一个资源,同时还在等待其他资源。
-
No Preemption 不可抢占:资源不能被系统强制收回,只能由持有它的线程主动释放。例如不能随意强制解除正在使用的 Mutex。
-
Circular Wait 循环等待:存在一个线程等待环:T1 等 T2 等…Tn 等 T1,每个线程都在等待下一个线程持有的资源。
⚠️ Coffman 是 Deadlock 发生的必要但不充分条件,不保证某次执行必然发生死锁。只要设法破坏四个必要条件中的至少一个,就可以防止相应类型的死锁。
Resource Allocation Graph
定义两种节点组成的有向图:
- Thread Node:圆形,表示线程 T。
- Resource Node:方形,表示资源类型 R;其中的黑点代表资源实例 (Instance),其个数 W 表示可独占数
⚠️ 请求边是 Thread 指向 Resource,分配边是 Resource 指向 Thread (以获得)
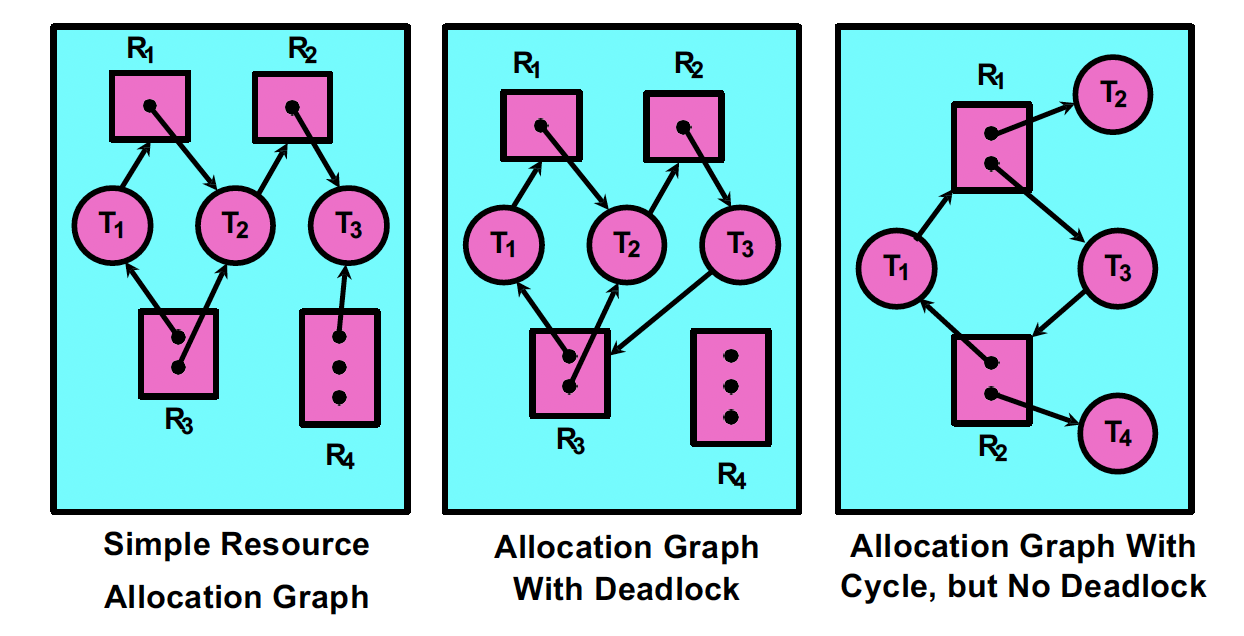
图存在 cycle 不代表必然存在 Deadlock。如果环中存在 W > 1 且未全部分配给环内的 T,就不存在死锁。
Deadlock Detection Algorithm
有没有一种顺序,让所有线程都能依次获得所需资源、完成执行并释放资源?
定义三种向量变量,按 R1 到 Rn 维度:
- FreeResources 表示当前每种资源还有多少可用实例;
- RequestX 表示线程 X 当前还在请求多少资源;
- AllocX 表示线程 X 当前已经持有多少资源。
向量之间的比较是逐元素比较,例如 [1,2] ≤ [2,3] True;[1,3] ≤ [2,2] False。
Avail = FreeResources
UNFINISHED = 所有线程
repeat:
    done = true
    for each thread X in UNFINISHED:
        if Request[X] <= Avail:  # 检查谁当前可完成
            Avail = Avail + Alloc[X]
            从 UNFINISHED 移除 X
            done = false
until done == true
思路:循环检查谁用当前资源可以完成任务并释放持有的资源,最终 UNFINISHED 剩下的线程处于 Deadlock。
- Deadlock Detection 使用的是当前 Request,而不是未来可能需要的最大资源 Max。
Dealing with Deadlock
处理死锁的四种策略:
- Prevention 预防:设计系统/代码时,破坏死锁必要条件
- Avoidance 避免:每次资源分配时,判断是否会进入不安全状态
- Detection & Recovery:允许死锁发生,再检测并解决
- Ignore (Denial) 忽略:不主动检测,交给应用或人工干预
Deadlock Prevention
-
破坏 Mutual Exclusion
① 资源依赖:提供足够大的资源或无限资源的幻觉 (例如 Virtual Mem.);
② 线程互相依赖 (数据依赖):难以解决,Mutex Lock 保护的共享数据无法简单取消独占。也不可能直接让线程独立 (不共享数据)。
-
破坏 Hold and Wait
① 不允许长期等待:常见于电话公司、以太网,因为需要反复重新尝试所以效率不高;
② All or Nothin’ 要求线程开始执行前同时申请所有所需资源:就不会出现多线程分别占有对方需要的资源。问题是资源利用率可能下降,因为线程提前占有资源 (即使当前不用),且容易 overestimate 所需资源。
-
破坏 Circular Wait
① Lock Ordering 强制所有线程按某个全局顺序请求资源:比如全局按 R 序号递增顺序 Acquire()。所有等待关系都只能指向更高编号的资源。若要形成 Cycle 就必须最终从高编号资源等低编号,不可能。
比如 Wormhole-Routed network (四个右转列车在口字岔口堵住) 可以用 dimension ordering (先东西后南北) 解决
Deadlock Recovery
-
“破罐破摔”:强制终止 kill 线程并放弃资源
-
破坏 No Preemption
在不终止线程的前提下,允许 OS 必要时强制收回资源 (Preempt 通常是异步 Asynchronous 的)。例如某些 Mem 资源可以被换出 (paging out to disk 时线程无法使用)。但不能随意强制释放 Mutex,否则可能破坏数据一致性 Coherency。
-
让事务回滚 (roll-back),释放已占用的资源,常见于数据库系统
Deadlock Avoidance
每次资源分配时,判断是否会进入不安全状态,若是则等待其他现场释放资源,不是就立刻分配资源——
假设系统有若干线程,每个线程可能继续申请资源。一个状态是 Safe 的,当且仅当:
存在至少一种线程完成顺序,使所有线程都能依次获得剩余所需资源、完成任务并释放资源。这个顺序是 Safe Sequence。
反之如果不存在任何 Safe Sequence,未来死锁无法避免就叫 Unsafe State。
Deadlocked → Unsafe 但 Unsafe 不代表已经 Deadlocked
因为 Unsafe 表示系统无法保证未来所有线程都能完成,并不代表它们现在已经互相等待。
Banker’s Algorithm
银行不能仅仅因为现在有钱,就立即批准每一笔贷款。因为批准某笔贷款后,可能出现:每个客户都拿到一部分钱,但没有任何客户能获得足够的钱完成项目。所有客户都无法还款。
银行家算法的目标是:简化忽略利息,在批准资源请求前,模拟分配后的状态,只有仍然存在 Safe Sequence 时才批准。
Max:和 Deadlock Detection Algorithm 不同的是,需要提前知道每个线程最大资源需求。Alloc:线程已经持有多少资源。Need = Max - Alloc (未来最多继续申请多少资金)FreeResources:系统目前剩余多少资源。
Deadlock Avoidance Algorithm:
Avail = FreeResources
UNFINISHED = 所有线程

repeat:
    done = true
    for each node in UNFINISHED:
        Need = Max[node] - Alloc[node]
        if Need <= Avail:
            Avail = Avail + Alloc[node]
            remove node from UNFINISHED
            done = false

until done == true
模拟完成时只加 Alloc 而不是 Max。因为线程为了完成任务,可能先临时借用 Need,随后把自己持有的全部资源归还抵消。
运行完成后会得到一条 Safe Sequence 或得到相互 Unsafe 的元素。
CSC3150 Lecture13 现代计算机系统的调度
Firmament (Cluster Scheduling)
以前我们讨论的 CPU Scheduling,通常是多个线程争夺一或多个 CPU,操作系统决定谁先执行
但数据中心有成千上万台服务器,应该把哪个任务分配到哪台机器—— Cluster Scheduling 集群调度
Firmament = Centralized Scheduling + Min-cost Flow + Fast Incremental Optimization
= Good Task Placement + Low Scheduling Latency + Large-scale Cluster Support
例如有三类任务:
- Interactive Jobs:交互式任务,要求几秒内完成。
- Long-running Services:长期运行的服务,需要稳定性能。
- Batch Jobs:批处理任务,通常用于提高资源利用率。
调度器需要同时实现两个目标:
Good Task Placement(好的任务放置):避免资源冲突,提高整体性能。
Low Scheduling Latency(低调度延迟):不能让任务长时间等待调度决策。
Centralized vs Distributed Scheduling
| Centralized | Distributed | |
|---|---|---|
| 决策方式 | 全局调度器统一决定 | 多个调度器分别决策 |
| 信息范围 | 全局信息 | 通常只有局部或不完整信息 |
| 优势 | 可以优化整体任务分配 | 决策简单、容易并行 |
| 缺点 | 全局计算可能很慢 | 容易产生次优分配 |
| 举例 | Quincy、Borg | Sparrow、Tarcil |
全局优化可能很慢:假设有 10,000 个任务和 10,000 台机器。每个任务可能有不同的机器偏好、资源需求和迁移成本。中央调度器必须考虑任务之间的竞争,才能做出整体较好的决定。
而分布式调度器可以更快地作出局部决策,但不一定知道其他机器的实际情况。
Firmament 的目标就是同时获得全局优化能力和低调度延迟。
Min-cost Flow Scheduling
Firmament 将任务分配问题转化为一个 Graph Optimization Problem:一些任务分别一对一指向一些 Machine (现实中可能继续指向其他 Machine) 直到任务完成全部指向 Sink。
⚠️ Min-cost Flow 优化的是整体 Cost,而不是让每个 Task 都选择自己 Cost 最低的 Machine。这也是全局调度和局部贪心调度的区别。
Firmament 不只是调度新任务,也可以重新考虑已经运行的任务:
- Migration:把任务从一台机器迁移到另一台机器。
- Preemption:暂停或抢占已有任务,为其他任务腾出资源。
因此它可以优化整个 Cluster 的任务分配,而不只是给新任务找一个空位置。
算法调度速度对比
-
Cost Scaling 大规模集群下过慢
-
Successive Shortest Path wcc 最快,但实验中扩展到约 100 台机器就很慢
-
Relaxation wcc 最差,但通常能实现亚秒级调度
Relaxation wcc 虽然很高,但在所研究的任务分配网络中,通常表现最好。原因是它可以利用当前已有的任务分配结果,不必每次从零开始求解。
Relaxation:先保留当前任务分配,再寻找能降低整体 Cost 的调整方式。Incremental Recomputing:新增任务时不必从零计算所有任务的所有分配。可以从当前方案出发,尝试局部调整,寻找新的低成本方案。
⚠️ Higher Utilization → Potentially Higher Scheduling Cost
当 Cluster Utilization 接近 100% 时,Relaxation 可能变慢。因为机器资源紧张,无法简单地将一个任务移动到空闲位置,可能需要连续调整多个任务。
Gandiva (AI Deep Learning Training Scheduling)
DLT
传统 GPU Scheduler 通常把深度学习训练任务当成普通大数据任务。
Non-preemptive/Exclusive:一旦某任务获得 GPU,就可能一直占有直到完成 (类似于 CPU FCFS)
问题一:High Latency——Head-of-line Blocking 队首阻塞 (类似于 FCFS Convoy Effect)
- 较大 DLT 挡住后面小推理任务,需要 time-slicing
问题二:Low Efficiency:初次分配后固定资源分配
- 导致利用率不均,资源分布不合理,需要 migration
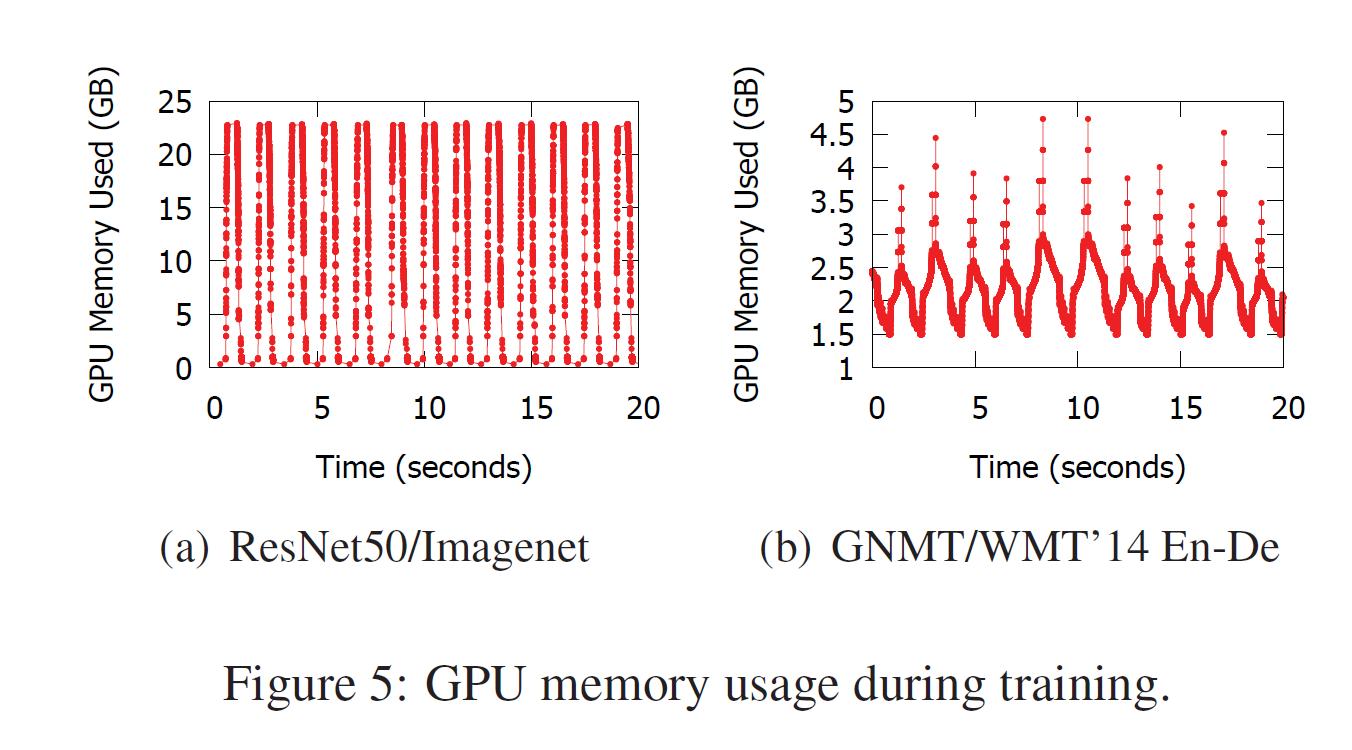
⚠️ Intra-job predictability:DLT 通常由大量 Mini-batches 构成。同任务的 Mini-batch 执行时间和资源使用模式具有较强的可预测性/周期性。
这意味着调度器可以用 Mini-batch 边界 (Iterative boundary) 做 time-slicing quantum,而不是随意打断训练—— Application Semantics-Aware Scheduling 利用任务本身运行特征调度。
Gandiva
更小 Latency (4.5x) + 更高 Efficiency (Troughput+26%) 的 DLT workflow
Mechanism 1 — Time-slicing:和传统 CPU Round Robin 很相似,解决长任务阻塞短任务
-
不同 Job 轮流使用 GPU,而不是一个 Job 长期独占。
-
Gandiva 的 Time Quantum 约为 q = 1 minute ≈ 100 mini-batches
暂停任务时等待当前 Mini-batch 完成,将必要的 GPU 状态复制到 CPU,暂停当前 Job 并切换到另一个 Job。
⚠️ 在 Mini-batch Boundary 暂停,可以显著降低切换成本 (≈ 50x)。因为此时训练任务处于相对明确的阶段边界,不必在一个 Mini-batch 的计算中途保存复杂的临时状态 (Application-aware Scheduling)。
Mechanism 2 — Migration & Packing:
-
Migration 迁移:解决任务分布不合理、资源碎片化。把一个 Job 从 GPU A 移到 B。整理碎片化资源,使多 GPU 任务获得所需资源;利用不同 GPU 的性能差异;改善整体负载分布。
-
Packing 打包运行:解决 GPU 资源未充分利用。把多任务放在同 GPU 上运行。多个只使用部分 GPU 资源的任务可能适合同时运行。
-
⚠️ GPU Utilization 上升,不一定代表有效吞吐量上升。假设两个任务分别运行时每秒完成 10 个 Mini-batches,Packing 后 GPU Utilization 增加,但由于相互干扰,每个任务每秒只能完成 4 个,那么 Total Throughput 反而下降:4+4=8<10。所以 Packing 并不一定有利。
Mechanism 3 — Application-aware Profiling:解决无法判断调整是否提高效率
- Gandiva 测量吞吐量指标而非靠使用率粗糙地判断:Useful Work = Time per Mini-batch (尝试并测量吞吐量变化确定 Migration/Packing 等调整是否保留)
- 称为 Introspective Scheduling 自省式调度
Synergy (Multi-resource Scheduling)
Synergy 提出深度学习训练不仅需要 GPU,也需要 CPU 和 Memory,不能只考虑 GPU 数量。
GPU-Proportional Allocation 的问题:传统 GPU-Proportional Allocation 按 GPU 数量比例分配 CPU 和 Memory:R = #R x GPU/#GPU。但不同 DNN 任务对 CPU 和 Memory 的需求差异非常大,不必与 GPU 成比例。
Resource Sensitivity:Synergy 通过分析每个 Job 对 CPU、Memory 等资源的敏感程度,进行更合理的分配。
Optimistic Profiling:Synergy 使用 Profiling 在专用服务器上测试任务的性能与资源分配之间的关系。改变资源,测量性能变化,找到能够达到最佳性能、同时消耗尽可能少辅助资源的配置。
Job Placement
知道每个任务需要多少资源后,怎样把这些任务合理地放进集群属于:Multi-dimensional Bin Packing 多维 (CPU, GPU, RAM…) 装箱问题。
任务能否放入某台服务器,需要所有维度都满足 Demand ≤ AvailableResources 这里的比较是逐分量比较。
Multi-dimensional Bin Packing is NP-hard
这意味着在一般情况下,寻找全局最优方案的计算成本可能非常高。因此 Synergy 使用接近最优的 Heuristic Scheduling。
Synergy 的调度策略
- 从待运行任务队列中选择 Job。
- 尝试按 Profiling 得出的理想资源配置放入集群。
- 如果放不下,尝试使用 GPU-Proportional Share。
- 必要时调整已运行 Job 的辅助资源配置,释放空间。
- 重复,直到没有可继续分配的 GPU 或任务。
⚠️ Synergy 并不是完全抛弃 GPU-Proportional Allocation,而是在资源紧张时把它作为 fallback config。
Makespan (finish time span) 改善约 1.4 倍;Average JCT (Job Completion Time) 改善约 1.5 倍;99th Percentile JCT 改善约 2 倍。