💻 CSC3150 Week 3 System Prog.: Files & Sockets/Pipes
Lithos
CSC3150 Lecture5 SysProg: Files
回顾:OS library 本身主要运行在 user level 作为 API,但需要真正让 OS 做事情时,会发起 syscall 进入 kernel。
Files and I/O in Unix
Unix (AT&T Unix) 促使 C 语言的诞生,也是 Linux / macOS 等类 Unix 系统的根源。
In Unix, Everything is a “file” (1974)
不是说所有东西都是硬盘上的
.txt文件,而是尽量让各种 I/O 对象都使用类似的操作接口
硬盘文件、socket/pipe、终端、显示器、网络 等都尽量抽象成 Syscalls:open()、read()、write()、close()
系统调用的“瑞士军刀”:ioctl() 用于执行那些不能用常规的读写 Syscall 表达的设备特定操作……比如设定散热马达转速。
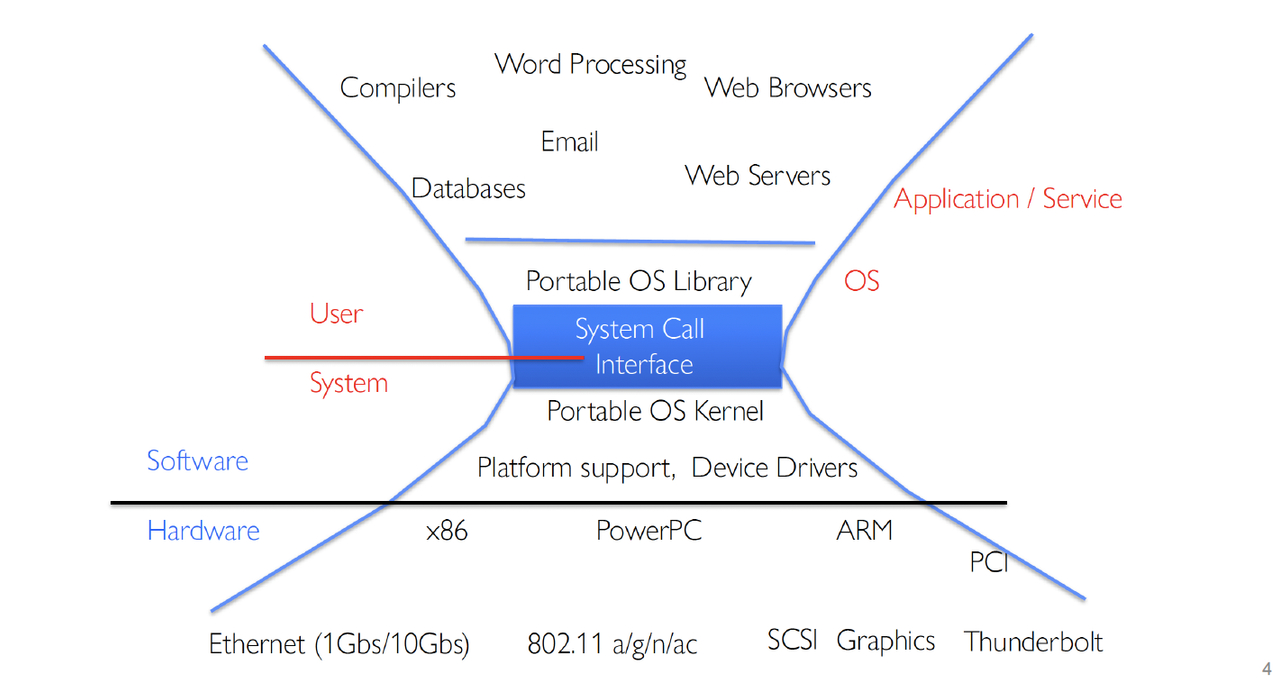
OS 之上有无数应用,下面各类硬件,中间尽可能维持稳定统一的接口,称为 narrow waist
POSIX: Portable Operating System Interface for Unix/Linux —— IEEE 为确保各类应用/软件能在类 Unix 系统 兼容 PORTABLE (部分对非 Unix 比如 Windows 兼容) 而规定暴露给程序的标准 APIs,比如 Syscall、pthread、Process Management APIs……以及文件系统应该有什么 OS抽象——
- File 文件:Named sequence of bytes 有命名的二进制序列 (48 65 6c 6c 6f …)。至于它们是 ASCII、JPEG、ELF-exe 还是 serialized object (JSON/XML),OS/POSIX 层完全不关心,这是上层 Lib./App. 的抽象。文件的读写是 Bytewise 的 (8-bit 为基础读写宽)。
- Metadata 元数据:文件的描述数据。大小、修改时间、Owner、安全信息、Access control…
- Directory 目录:包含文件或其他目录的文件夹“Folder”。
-
每个进程都有自己的 CWD (当前工作目录),可用 Syscall 设置
int chdir(const char *path); -
Hierarchical naming 层级命名体系:无需全局绝对名,每级目录负责其下层的命名,形成寻路的 Path 路径。
绝对路径无视 CWD: ~/xxx 相当于 /home/xxx。⚠️ 所有 “/xxx” 都是从根目录开始的绝对路径;
相对路径相对于 CWD: xxx/xxx 指定目录下、./xxx 当前目录下、../xxx 父级目录下。
-
Bash:
cd(change directory)、pwd(path to working directory)、ls(显示仓库下的内容) -
Links and Volumes 链接与综卷
⚠️ POSIX ≠ Syscall,前者是 IEEE 标准,后者是具体 OS 的实现机制。
High-Level I/O Abstractions
I/O Stack:
High-Level I/O       Streams (buffered I/O)
      ↓
Low-Level I/O        File Descriptors
      ↓
   Syscall           open/read/write/close
      ↓
 File System         Open File Descriptions
      ↓
 I/O Driver          Commands and Data Transfers
      ↓
   Hardware          Disks, Flash, Controllers, DMA...
high-level file API: Stream 文件流
Stream 流:对一串数据进行顺序读写的抽象,维护当前读写位置;底层数据本质还是 byte sequence (file)。
⚠️ FILE 是 C 标准库 Libc/stdio 定义在 User Space 的高层级封装,以表示和管理打开的文件流的数据结构类型。kernel 有完全不同的数据结构。
打开文件流:fopen() 打开文件并建立 stream;返回指向 FILE 数据结构的指针,失败则返回 NULL ——
FILE *fopen(const char *filename, const char *mode);
FILE *filep = fopen("hello.txt", "r");  // E.g.
fopen modes:
-
r:打开已有文件,只读。r+:读写 (Bytewise overwrite)。⚠️ 文件必须存在否则打开失败 -
w:打开用于写;不存在就创建,存在就 truncate to 0。w+:读写,存在原文件就清空。 -
a:append,写到文件末尾;不存在则创建。a+:读写 (EoF)。 -
以原始二进制格式打开:rb, rb+, wb, …
⚠️ 以 r/w 模式打开文件,file position (
filep) 自动位于文件开头;a 则一般在末尾 (取决于 C 实现)。
常见 API:fgets()、fputs()、fread()、fwrite() ……
关闭文件流:int fclose( FILE *filep );
high-level stream API: studio.h 标准 I/O 流
C 程序启动时,通常已经存在三个 high-level stream (FILE * stream):stdin、stdout、stderr。
FILE * stdin:标准输入流;scanf(...) ≈ fscanf(stdin, ...)FILE * stdout:标准输出流;printf(...) ≈ fprintf(stdout, ...)FILE * stderr:标准错误输出流;通常用fprintf(stderr, ...)
⚠️ 标准流是抽象接口,不等于硬件;Shell 可以通过 redirection / pipe 改变它们连接的对象;
- 比如
./a.out > result.txt(stdout → txt) - 这体现出 stream 抽象的价值:不关心输入/出对象是键盘/txt/麦克风…统一接口!——⚠️ All can be redirected
⚠️ 标准流也不等于函数:C 函数 (如 printf) 把字符写到标准流 (如 stdout) 中。
程序间通过标准输入/输出流组合 composition,而不需要彼此认识。
-
cat hello.txt | grep "World!"(A stdout → pipe → B stdin)Shell 创建一个 pipe,并把 cat 的 stdout 连接到 pipe 的写端,把 grep 的 stdin 连接到 pipe 的读端。
所以
<、>、|可以统一理解成 Shell 在程序运行前配置它们的标准 file descriptors 后面接到哪里
char, str-wise I/O
int fputc( int c, FILE *fp ); // return c or EOF on err
int fputs( const char *s, FILE *fp ); // return > 0 or EOF
int fgetc( FILE * fp );
char *fgets( char *buf, int n, FILE *fp );
E.g.: 从 input.txt 读一个 char 写入 output.txt 循环直到 EoF 结束——深拷贝 input.txt 到 output.txt:
FILE *input = fopen("input.txt", "r");
FILE *output = fopen("output.txt", "w");
int c;
c = fgetc(input);
while (c != EOF) {
    fputc(c, output);
    c = fgetc(input);
}
fclose(input);
fclose(output);
注:fgetc() 是自动自增的:每成功读取一个字符自动把 stream 的 file position 向后移动一个字符 (Byte)。file position 在这里是 input 指针。
⚠️ stdio buffer 是 libc 为 FILE * 在用户空间维护的临时内存,用于减少实际 I/O/syscall 次数
- 你表面上可能调用了很多次
fputc(),但通常并不是每次都 Syscall (write()) —— 不可能每写一次数据就进行昂贵的 syscall,而是缓冲区攒起来,再一次性交给 kernel。
block-wise I/O
size_t fread(void *ptr, size_t size_of_elements,
    size_t number_of_elements, FILE *a_file);
size_t fwrite(const void *ptr, size_t size_of_elements,
    size_t number_of_elements, FILE *a_file);
E.g.:每次最多读 1024 个 char 到 buffer,然后把实际读到的 length 个字符写出去,直到 fread 返回 0——依据是深拷贝 input.txt 到 output.txt:
char buffer[1024];
size_t length = fread(buffer, sizeof(char), 1024, input);
while (length > 0) {
fwrite(buffer, sizeof(char), length, output);
length = fread(buffer, sizeof(char), BUFFER_SIZE, input);
}
注:省略 fopen / fclose。
⚠️ 系统编程不能假定成功:必须检查 return value!
上述的所有代码现实中都不能省略检查,比如:
FILE* input = fopen(“input.txt”, “r”);
if (input == NULL) {
// Prints our string and error msg
    perror(“Failed to open input file”);
}
因为文件可能:不存在/没权限/路径错/ IO 出错/硬件冲突/硬件空间耗尽……
控制文件流指针位置
int fseek(FILE *filep, long int offset, int whence)
long int ftell(FILE *filep)
void rewind(FILE *filep)
-
fseek:主动移动当前 I/O 流指针位置,成功则返回 0whence三个锚点:SEEK_SET 从文件开头算、SEEK_CUR 从当前位置算、SEEK_END 从文件末尾算 -
ftell:返回当前指针位置 (相对于开头的 byte offset),失败时返回 -1L比如 getc() 运行3次后,ftell 返回 3 (第 4 个字节)
-
rewind:回到文件开头,无返回值相当于
fseek(fp, 0, SEEK_SET);并清除 stream 的 EOF/error 状态
所以……
如果我想从第 42 个字符开始读?
fseek(input, 41, SEEK_SET);
int c = fgetc(input);
从最后一个字符往前读?
fseek(input, -1, SEEK_END);
int c = fgetc(input);
(以上是用户常看到的抽象,接下来进入 OS Kernel 眼中的抽象)
Low-Level I/O Abstractions
Low-Level I/O 抽象更直接,并且处于 syscall interface。相比 High-Level 对用户没那么易用,主要面向 Kernel。
Application
    ↓
FILE *                    ← C stdio abstraction
──────────────────────── libc/stdio, buffer&formatting
POSIX / syscall interface
    ↓
int fd                    ← 用户看到的 handle
════════════════════════ syscall boundary
Kernel
    ↓
struct file / inode ...   ← OS Kernel 自己的内部实现
Low-level POSIX I/O 提供最基础的 OS I/O abstraction——用
fd统一引用 kernel 管理的打开 I/O 对象;High-level C stdio 在其上提供FILE *stream abstraction,增加 buffering、formatted I/O 和更方便的字符/行/块操作。
用户程序调用的是 POSIX标准下 libc 暴露的函数接口,它通过 system-call mechanism 请求 kernel 执行相应服务—— open()、read()、write()、close()。E.g.:
int open(const char *filename, int flags [, mode_t mode])
int fd = open("hello.txt", O_RDONLY);   // e.g.
⚠️ 返回值突然从上一层的指针 FILE * 变成一个整数索引—— File Descriptor (FD)
-
open()一个文件时,Kernel 会创建一个 open file description (打开文件描述),记录这一次“打开”的状态,它描述的不是“文件本身”,而是这次打开文件的实例 ( instance of an open file.)——⚠️ 每次打开不同。 -
这解释了为什么用户拿到的是
int fd而不是 Kernel pointer:Kernel 把真正的 open file description 保护在 Kernel Space,只给进程一个fd来安全的间接引用它。 -
open()成功返回 integer FD;失败返回负值并设置全局errno变量。 -
多个 fd 也可以指向同一个 open file description,此时它们会共享 file offset。这和“分别
open()两次”是不同的。(讨论 Kernel 时展开)
fd 与 FILE *
⚠️ Everything is a “file”……“C 程序启动时,通常已经存在三个 high-level stream (FILE * stream):
stdin、stdout、stderr”,而这三个高级文件流抽象对应在这层占据 fd = 0、1、2,所以 open() 一个普通文件通常从 fd=3 开始。STDIN_FILENO = 0;STDOUT_FILENO = 1;STDERR_FILENO = 3
索取 fd 值:
int fileno (FILE *stream)
fileno(stdout);   // int 1
如果本来不得不用 low-level API 获得了 fd,但后面想使用 high-level stdio 的便利功能,需将 fd 转化为 FILE * 抽象:
FILE * fdopen (int filedes, const char *opentype)
FILE *fp = fdopen(fd, "r");   // 高低层抽象间的“桥梁”
⚠️ High/Low Level I/O 是两个可供程序员选择的 API 层次;High-level 通常建立在 Low-level 之上,而
fdopen()允许在必要时从已有 low-level fd 接入 high-level stream⚠️ 即使你只手写 high-level,底下仍然存在 low-level (lib c);反之你也可以只写 low-level。
但绝大多数情况下用户程序选一套抽象写,不会同一个文件又
fopen()又open()!
Low-level file API
read() 对应 fread()
ssize_t read(int fd, void *buffer, size_t maxsize)
// E.g.
char buf[1000];
int fd = open("lowio.c", O_RDONLY);
ssize_t rd = read(fd, buf, sizeof(buf));
-
从
fd指向的对象 (lowio.c) 中,最多读取 1000B,放入buf,取决于对象文件实际大小。返回 100 ≡ 读了 100B;返回 37 ≡ 只读了 37B;返回 0 ≡ EOF;返回 -1 ≡ error
——最多一次读
maxsize,实际可能读更少!
write() 对应 fwrite()
ssize_t write(int filedes, const void *buffer, size_t size)
//E.g.
write(1, "hello\n", 6);
-
从
*buffer指向的对象读取 6B 写到filedes。这里是stdout,相当于不经过printf的格式化和 stdio buffering 直接输出。write(42, "hello\n", 1000000);这句指令会越过字符串边界继续读取不属于这个对象的内存,属于 UB undefined behavior,可能输出垃圾数据,也可能崩溃。
lseek() 对应 fseek()
off_t lseek(int fd, off_t offset, int whence)
// E.g.
lseek(fd, 10, SEEK_SET);
-
把 kernel 中这个 open file description 的 file offset 移到第 10 byte。
whence三个锚点:SEEK_SET 从文件开头算、SEEK_CUR 从当前位置算、SEEK_END 从文件末尾算⚠️
lseek()直接改的是 kernel 的 offset,不会自动同步FILE *层的 buffering/position 状态。 -
因此同一个底层文件上混用
fseek/fread和lseek/read要小心
Other Low-Level I/O Operations
-
前文提到过的
ioctl:对设备做read/write以外的特殊控制 -
Pipe 在 Kernel 的实现:
int pipe(int pipefd[2]);返回 0 成功,-1 失败,传进去一个长度至少为 2 的int数组;函数会修改这个数组,把两个 fd 写进去(0 读 1 写)写到
pipefd[1]的数据可以从pipefd[0]读取——创建进程间传数据的 channel -
复制 (重定向) fd:
int dup2(int old, int new);;int dup(int old);让 fd 重定向/复制到另一个 fd -
Memory Mapping:把文件映射到虚拟内存,用内存访问方式操作文件
-
Async I/O:发起 I/O 后不必一直阻塞等待(调度器并发)
-
File Locking:防止多个进程同时冲突地操作文件
Broader View Accross Low&High I/O
POSIX I/O design patterns
-
Open before use:先建立一个 I/O context/handle,并在打开阶段完成权限检查和初始化。High-level 是
FILE *,low-level 是fd。 -
Byte-oriented:low-level I/O 对应用程序提供一种统一的字节流式抽象 (Byte abstraction),隐藏 HDD/SSD 实际可能按 block 工作等硬件细节。这种思想也会反映到上层 stream API。
字节是大部分硬件都能接受的 Least common denominator (最小公分母)
-
Explicit close:资源使用完显式关闭。High-level
fclose(fp),low-levelclose(fd)。
stdio & kernel Buffers
write(1, "Beginning of line ", 18);
sleep(10);
write(1, "and end of line\n", 16);
- 这里没有 stdio user-space buffer,且终端输出延迟不大,立刻看到显示第一句,十秒后出现另一句。
printf("Beginning of line ");
sleep(10);
printf("and end of line\n");
- 受到 stdio buffer 影响,结果应当是
Beginning of line and end of line。
-
OS 内核的物理读写都是缓冲式的:High-level stdio 有 user-space buffer;low-level POSIX I/O 下面,Kernel 自己也可以有 kernel-space buffering/cache。即使你不用
FILE *,绕过 stdio buffer,还存在内核缓冲/缓存:- 读:你只要 10B,但硬盘可能必须按 block 读取,整个块被读到 Kernel,并取所需的 10B。剩余数据可以留在 kernel 缓存中;
- OS concurrency / scheduling:如果发生 Kernel cache miss,CPU 会从当前 I/O 切到其他进程;
- 写:类似的,
write()返回 100,不一定意味着这 100B 已经物理写到磁盘。
Kernel Buffer 存在的核心原因:设备慢,且喜欢按块工作 (尤其磁盘)
⚠️
FILE *内部实际上包含一个 fd,也包括 user-space buffer、current state … 而fopen()内部最终会调用open()。
            <USER SPACE>
             FILE *fp       ← High
          ┌──────────────┐
          │ stdio buffer │
          │ ...          │
          │ fd = 3       │
          └──────┬───────┘
                 │
          fread()/fwrite()
                 │
          Buffered syscall
                 ↓
════════════════════════════════════
             <KERNEL>
              fd = 3        ← Low
                 ↓
        Open File Description
                 ↓
                File
                 ↓
            Disk / Device
两层的缓冲设计对比:
⚠️ stdio buffering:写数据不会每次都独立给 Kernel;
- 为了减少 syscall overhead:减少次数,增大单次数据量。
- 由于内核的 functionality:不关心 (agnostic) 数据的抽象定义和 formatting,只关心 Byte (
read(fd, buffer, n);)。用户想要按行/字符串读只能靠高层的getline(...)、fgets(...)。kernel buffering:Kernel 已经接收数据,但底层设备操作可能尚未完成。
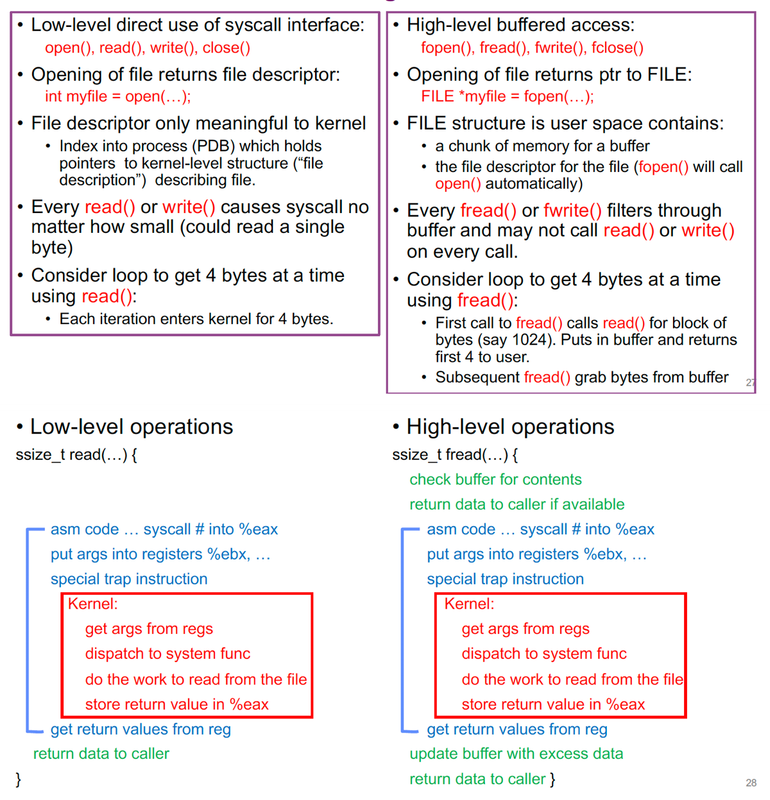
I/O in Kernel
File Descriptor & Open File Description
Low-Level I/O 使用 open() 返回的 int fd 在 Kernel 中需要一个解释器描述其对应文件的物理位置——
Open File Description:1. Where is the file data on disk? 2. Current position within the file?
Kernel 为每个进程维护 FD 到 Open File Description 的映射 (Open File Table):
-
不同进程的 fd 可以重复编号 (进程不共享),同进程的线程共享 fd table。
-
某进程的多个 fd 可以指向同个 OFD,此时它们共享 file offset (比如使用
dup()时)。 -
多个进程的同名 fd 可以指向同个 OFD,比如使用
fork()时。 -
同个文件可以有多个 OFD,比如
open()多次,每次open()都会新建 OFD。
同一个磁盘文件可以只有一个文件身份,但可以有很多个打开实例 OFD ——类似于不同进程在同本书里各自夹书签。
⚠️ Linux 的 OFD 保存一次“打开实例”的状态,其中包括指向文件对象 (inode) 的信息,以及
loff_t类型的当前文件位置f_pos。因此每次独立的open()通常创建新的 OFD,使不同打开实例拥有独立的 file offset,互不影响读取进度。
File Operations in Kernel
int fd = open("foo.txt", O_RDONLY);
假设返回 3,进程新建 FD table 记录 3;Kernel 在 Open File Table 新增一条 OFD,并建立 fd=3 与其的映射。OFD 包括 foo.txt 的 inode 和 position = 0 等等。
read(3, buf, 100);
若成功读取 100B,OFD 的文件内部索引变化为 position = 100。
close(3);
fd=3 及其映射从该进程的 FD table 和 Kernel OFT 中移除。
如果暂不关闭,改为 fork() 这个进程:⚠️ fd 会被拷贝,两者指向同个 Kernel OFD!(Fd Aliasing)
- ⚠️ 对于进程来说反常的是:子进程的 read() 产生 position 变化会影响父进程,vice versa。
        Parent                 Child
        FD table              FD table
           3                     3
           │                     │
           └─────────┬───────────┘
                     ↓
          SAME Open File Description
          ┌──────────────────────┐
          │ file = foo.txt       │
          │ position = 100       │
          └──────────────────────┘
⚠️ 并且如果父子进程有一个活着,对应的 OFD 就不会移除,直到不存在任意进程的任意 fd 与它关联。即使父进程 close(3),也不会影响子进程。
这和“fork() 后父子地址空间相互不干扰”矛盾吗?
——不。因为 OFD 不在用户进程的 address space 里!它们在共享一个 Kernel Object。
Lecture6 SysProg: Sockets&Pipes
进程间共享OFD
Fd Aliasing 是典型的进程间共享资源的例子 (共享 OFD)
比如,从终端启动程序,程序又 fork() 出子进程。父子进程都可以 printf(); 到同一个终端窗口。因为子进程继承了标准输出对应的资源引用。
同样的,子进程执行 close(0),只会关闭自己的标准输入 fd,父进程仍然可以从自己的 0 读取输入。反之亦然。
OFD 可以通过 fork 跨进程共享,对资源的引用又可以分别关闭。
IPC (跨进程通信)
Inter-Process Communication (进程间通信):非父子进程可以让通过文件跨时间/进程传递信息——进程 A 写入 write(wfd, wbuf, wlen);,进程 B 再读取 n = read(rfd, rbuf, rmax);。但对于“发出一段数据,对方接收并处理”的需求,队列 Queue 更自然:
- 生产者 –write–> 队列 –read–> 消费者
- 必须符合 file I/O
- 普通文件中的内容不会因为被读过就消失;通信队列中的字节被读走后,就从该接收队列中消耗掉了
如果两个进程在不同机器上,仍然可以使用类似接口—— socket 抽象
Request-response (请求-响应协议) 是一种网络通信模式:客户端发送请求、服务器接收请求并执行操作、服务器发送响应、客户端接收响应。
Socket
Socket 是网络 IPC 的通信端点抽象,与文件抽象很像。 一条连接的两端 (endpoints) 分别由两个 socket 表示,之间由队列暂存结果。按照英语词源可以想象成程序插入网络的插座口。(“網路插座”——台译)
-
我看“套接字”这个翻译完全可以和“卷积”、“杂化”、“闭包”这些教育界的垃圾翻译坐一桌。 -
大部分 OS 都提供 socket 抽象,即便它们不符合 UNIX I/O 的其它规范。UNIX 中最早出现于 4.2 BSD,现在 socket 由 IEEE POSIX 规范化。
-
socket 抽象对于任意类型网络通用:Local、Internet (TCP/IP, UDP/IP)、老古董 (OSI, Appletalk, IPX…)
程序拿到的仍然是一个 fd,但它背后对应的硬盘文件变成了通信端点。
write(sockfd, ...):把数据交给发送方向 (向输出队列入队)read(sockfd, ...):从接收方向取出数据 (从输入队列出队)- 同一个已连接 socket fd 可以用于读和写
概念上讲每个 socket 都有 input 和 output 2 个缓冲队列。因此,write 成功并不表示对方程序已经读到或处理完数据。
⚠️ Socket 与普通文件接口相似,但并不支持所有文件操作。例如,不能对 TCP 字节流使用 lseek,要求“跳回之前的位置再读”,因为 TCP 流不存在 offset (文件位置) 的概念。还有 pread()/pwrite() (不存在按 offset 读写的说法)、mmap() (没有虚拟内存映射)、ftruncate() (不能截流)。
“双向、可靠、有序的字节流”讨论的是 TCP 场景,不能直接套到所有 socket 上。
类似的,Pipe 是本机上单向、单队列、父子进程继承的跨进程通信。
TCP socket 只是通信中的基础框架,实际通信还需要:1. 应用层定义哪些字节算一条完整信息 (chunk)?2. RPC 提供网络抽象和跨环境/字节序/操作系统翻译。3.
Example: Echo Server
Echo 服务器的功能很简单:收到什么,就原样返回什么。
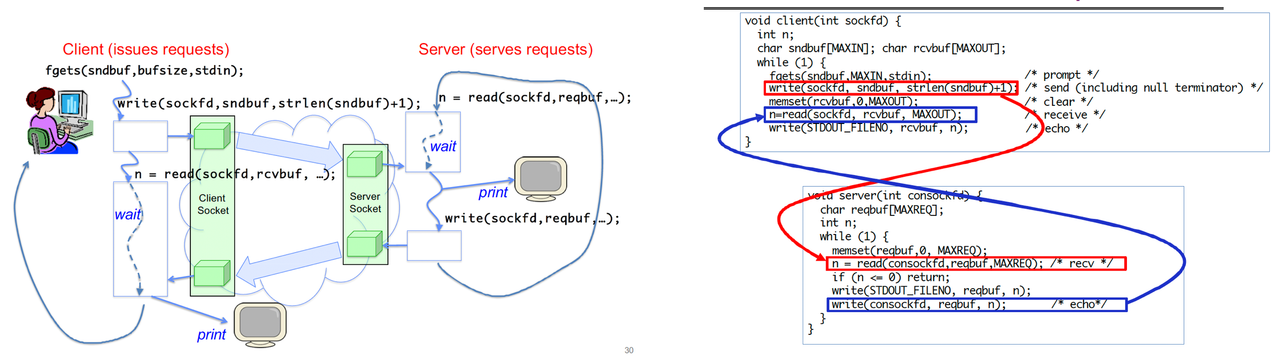
客户端核心代码:
fgets(sndbuf, MAXIN, stdin);
write(sockfd, sndbuf, strlen(sndbuf) + 1);
memset(rcvbuf, 0, MAXOUT);
n = read(sockfd, rcvbuf, MAXOUT);
write(STDOUT_FILENO, rcvbuf, n);
五句分别是:从标准输入读取一行,把输入 (包括字符串结尾 \0 ) 发给服务器,清空接收缓冲区,接收服务器返回的字节,把实际收到的 n 个字节输出到屏幕。
服务器核心代码:
n = read(consockfd, reqbuf, MAXREQ);
if (n <= 0) return;
write(STDOUT_FILENO, reqbuf, n);
write(consockfd, reqbuf, n);
服务器收到数据后,如果非空非错,在自己的终端显示,再通过网络发回客户端。
-
n == 0:对于这里的 TCP 流,表示对方结束发送,且可读取的数据已耗尽。 -
n < 0:发生错误。
⚠️ 我们假设 socket 可靠 (不丢失)、有序 (FIFO),不代表一次读到完整消息——TCP 只是提供有序字节流,并不保留应用程序每次
write的边界。
一次 write 不对应一次 read,可靠有序不保证一次 read 返回完整请求,只会读当前在队列的东西,没有数据就等待,有多少数据就返回多少,对方发送结束且读到结束时返回 0 (EoF)。同样的,程序也应处理一次 write 只写入部分字节的情况。
这解释了为什么我要发送 '\0':如果接收端循环读取并检查终止符,可以用这个字节表示一条字符串消息的结束。
Socket: IP
Hostname 主机名:用来标识网络中某一台具体机器或设备的名称。主机名通常是域名的完整形式,比如 www.blog.nero-lithos.com 中 www 是 host,后半部分是域名,理论上只要可以用于寻路到主机就是主机名。
DNS 把主机名解析成 IP:
- IPv4 是 32 bit:
10.31.31.254,掩码255.255.240.0 - IPv6 是 128-bit:
fe80::87::1b0b::9d78::3e6d
Port 端口:访问交给主机 (服务器) 上的哪个程序?
-
127.0.0.1:5173 常见 localhost dev 默认端口
-
0–1023:知名或系统端口,例如 HTTP 的 80、HTTPS (secure web) 的 443。 -
1024–49151:注册端口,由 IANA 分配服务。 -
49152–65535(215+214 to 216−1):动态或私有端口范围,自动分配的短时端口 (ephemeral ports)
TCP/IP 下,服务器中有两种不同用途的 socket:
| 类型 | | 用途 | | 主要操作 |
|---|---|---|
| 监听 socket,listening socket | | 等待并接收新连接 | | listen、accept |
| 已连接 socket,connected socket | | 与一个特定客户端交换数据 | | read、write |
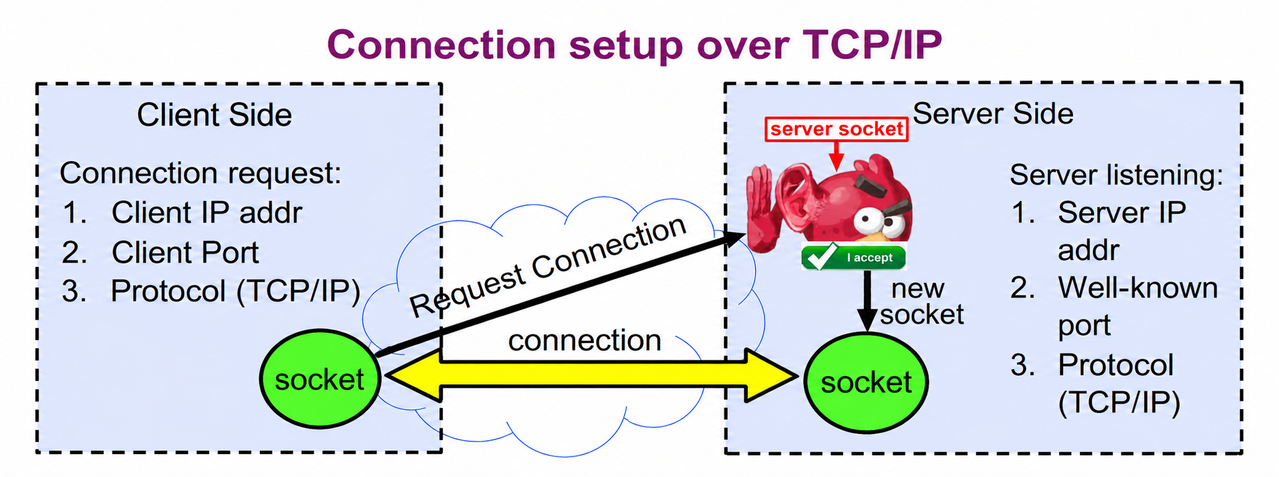
可以把监听 socket 理解成无法读写的接待台,accept() 则把一个来访者交给专门的服务窗口:返回一个新的 fd,原来的监听 fd 仍然保留。用新 fd 与这个客户端通信;继续用原 fd 接收其他连接。关闭用于通信的新 fd,不会关闭原监听 fd。
识别每个客户-主机连接的 5 元组 (5-tuple):
- Source IP address
- Destination IP address
- Source port number
- Destination port number
- Protocols (always TCP here)
端口:
- 客户端口一般由 OS 在 socket 建立时自动选择 (无规律)
- 主机端口通常是 80 (http)、443 (https)、25 (sendmail) 等等 0~1023 的知名端口
Web Server
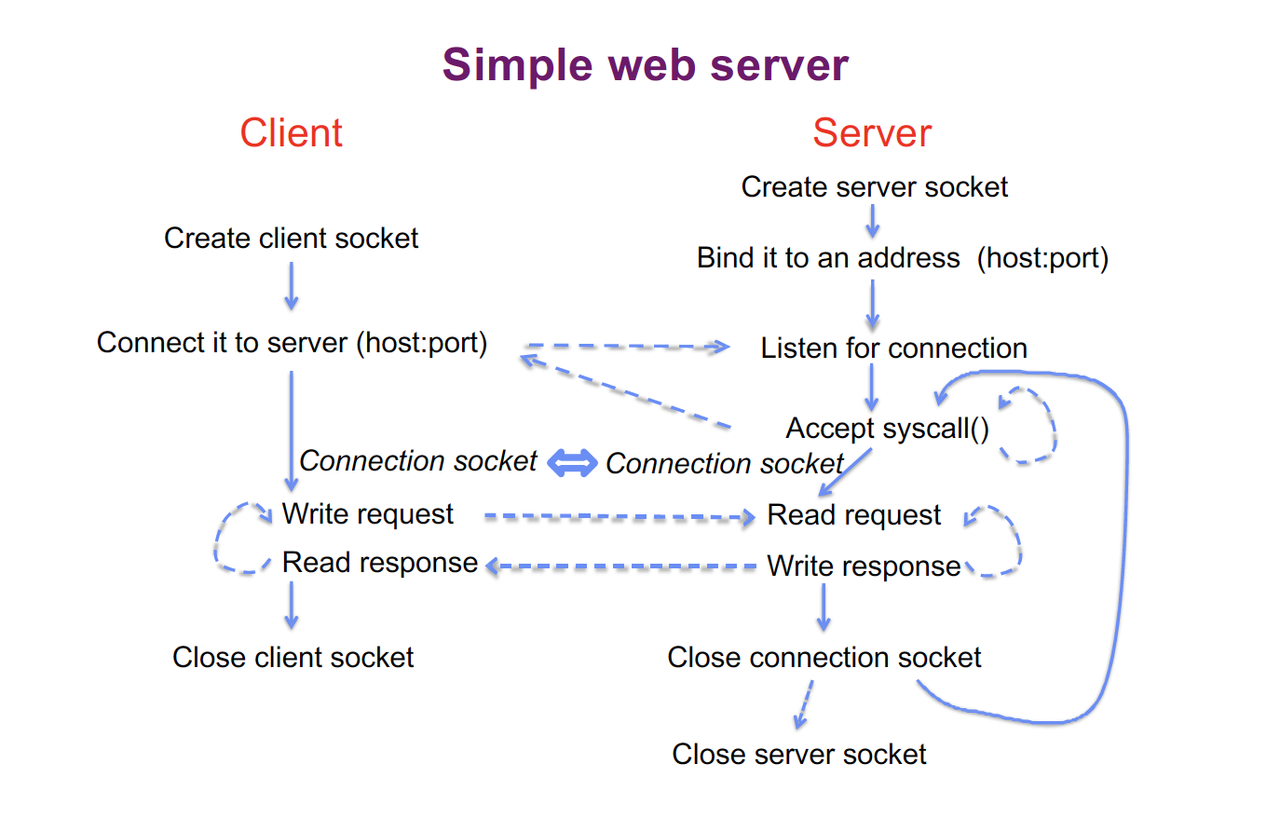
客户端和服务器的工作顺序不同:
-
客户端:解析服务器地址、
socket()创建 socket、connect()发起连接、连接后read/write……close() -
服务器:
socket()创建 socket、bind()绑定本地地址与端口、listen()开始监听、accept()取出一个连接得到新conn_fd、用新conn_fd进行read/write,完成后关闭。
socket(...);    // 创建通信端点
bind(...);      // 指定本地地址和端口
listen(...);    // 将 socket 用作监听端点
accept(...);    // 接收一个连接,返回该连接的新 fd
connect(...);   // 客户端向指定地址发起连接
hints.ai_family = AF_UNSPEC;     // 不限定只使用 IPv4 或 IPv6
hints.ai_socktype = SOCK_STREAM; // 请求流式 socket;即 TCP
int rv = getaddrinfo(host_name, port_name, &hints, &server);  // client
int rv = getaddrinfo(NULL, port, &hints, &server);  // host
进程服务器的并发
服务器将每个连接作为独立进程,并与服务器自身进程隔离以自保。
用了 fork(),服务器仍可能不并发:
-
基础服务器模型:服务器自己处理连接。
如果连接 A 很久不结束,服务器就迟迟无法开始服务连接 B。内核可能暂时把其他连接排队,但排队不等于应用已经在服务它们。
while (1) {
    int conn_fd = accept(listen_fd, NULL, NULL);
    serve_client(conn_fd);
    close(conn_fd);
}
-
每个连接都有自己的进程:连接交给子进程,但父进程 (监听) 马上等待。
假设
fork()成功,子进程负责处理客户端,父进程保留接收新连接的职责。独立进程提供地址空间隔离:子进程的普通内存错误不直接修改父进程的内存。但父进程紧接着调用 wait(NULL),仍然一次只服务一个客户端。
int conn_fd = accept(listen_fd, NULL, NULL);
pid_t pid = fork();
if (pid == 0) {
    close(listen_fd);
    serve_client(conn_fd);
    close(conn_fd);
    exit(0);
} else {
    close(conn_fd);
    wait(NULL);
}
- 真·并发:父进程不在每轮等待。
// Socket setup code elided…
listen(server_socket, MAX_QUEUE);
while (1) {
    // Accept a new client connection, obtaining a new socket
    int conn_socket = accept(server_socket, NULL, NULL);
    pid_t pid = fork();
    if (pid == 0) {
        close(server_socket);
        serve_client(conn_socket);
        close(conn_socket);
        exit(0);
    } else close(conn_socket);
    // wait(NULL); 不等子进程
}
close(server_socket);
线程服务器与线程池
多进程之外,也可以让服务器每收到一个连接,就启动一个线程来处理。
主线程:accept → 创建工作线程 → 继续 accept 工作线程:处理连接 → 关闭连接 → 结束
线程的生成通常比进程更轻量,Lower overhead spawning-process。放弃进程隔离的安全性 (多线程访问共享数据时,需要同步防止竞争 + 出错会影响整个服务器内存。),换取更快的创线程/切线程
⚠️ 与多进程不同的是,同一进程中的线程共享 fd table。因此不能照搬多进程版本的做法:主线程创建工作线程后,不能立即关闭那个仍要由工作线程使用的
conn_fd,关闭会影响同一进程中的其他线程!连接由工作线程用完后关闭。
但“每个连接创建一个线程”也有问题:连接太多时,线程数量可能失控 (unbounded),消耗内存并增加调度开销。
线程池则是:预先创建有限数量的工作线程,不断从队列中取任务。这样可以控制同时处理连接的数量,并复用线程。真正实现时,队列访问和等待唤醒必须正确同步。
Pipe
Pipe 匿名管道:用于同一台机器上的跨进程单向单队列字节流通信。父子进程继承 pipe 配置。
单进程 std I/O Pipe:
char *msg = "Message in a pipe.\n";
char buf[BUFSIZE];
int pipe_fd[2];  // 0读端 1写端
if (pipe(pipe_fd) == -1) return -1;
ssize_t writelen = write(pipe_fd[1], msg, strlen(msg)+1);
printf("Sent: %s [%ld, %ld]\n", msg, strlen(msg)+1, writelen);
ssize_t readlen = read(pipe_fd[0], buf, BUFSIZE);
printf("Rcvd: %s [%ld]\n", msg, readlen);
close(pipe_fd[0]);
close(pipe_fd[1]);
(pipe_fd[0] = 3 表示从 fd=3 读取)
先创建 pipe,再 fork,父子进程才会继承对同一条管道的引用 (fork-native)。如果父子进程各自单独创建 pipe,得到的是不同管道,不会自动相连。
通过关闭一者的写端,另一者的读端,就可实现单向通信:
int p[2];
pipe(p);
pid_t pid = fork();
if (pid > 0) {
    close(p[0]);            // 父进程不用读端
    write(p[1], "hello", 5);
    close(p[1]);            // 发送结束
    wait(NULL);
} else if (pid == 0) {
    close(p[1]);            // 子进程不用写端
    char buf[100];
    ssize_t n;
    while ((n = read(p[0], buf, sizeof(buf))) > 0) {
        write(STDOUT_FILENO, buf, n);
    }
    close(p[0]);
    _exit(0);
}
数据经过内核中的管道,因此父子进程即使有独立地址空间,也能通信。与 TCP 流类似,一次 read 也不保证读到一整条应用消息。管道容量同样有限,缓冲区满时写入也可能等待。
对于父子进程通信,匿名管道很方便:
- 没有文件路径,不需要通过文件名找到对方。
- 不用于持久保存数据。
- 可以通过
fork()自然继承。 - 内核提供缓冲及相应的等待行为。
相比普通文件,管道更适合“生产者写入、消费者读取”的连续数据流。相比跨机器 TCP socket,管道不需要设置 IP、端口和网络连接。虽然 socket fd 同样可以被 fork() 继承 ,但匿名管道尤其适合通过继承直接建立本机进程间通道。
IPC 总结
常见情况下的 IPC 优先选择:
- 同一线程内部:函数调用
- 同一进程的不同线程:共享内存,配合同步
- 父子进程:pipe
- 同一机器上互不相关的进程:UNIX domain socket、files (named shared memory)
- 不同机器上的进程:socket