💻 CSC3150 Week 1-2 OS: Abstractions, Threads&Processes
Lithos
CSC3150 Lecture1 OS Basics
课程网站。你可以通过改变以下链接中的“lecxx”访问所有课件:https://yunmingxiao.github.io/courses/csc3150-26spring/lectures/lec01.pdf。
Basics
OS 是应用程序软件和硬件之间的一层软件。应用程序通常不会直接控制 CPU、内存、磁盘、网卡,而是通过 OS。
OS 把真实复杂的物理硬件接口,包装成一个简单安全的“虚拟世界(A Virtual Machine)”。典型例子就是虚拟记忆,没人想在终端里写“请读取 SSD 第 1847293 个 block”…这就是 OS 核心工作之一:Abstraction (抽象)。
OS 很难设计……
Interface across huge diversity of devices——手机、汽车、摄像头都有 OS,硬件要统一接口
Commands have varied latency——最快 (L1 Cache Reference) 和最慢 (Intercontinental Package sending) 之间可以相差 8 个数量级。
Systems (Computer System, Applications …) are getting ever-more complex——硬件升级、安全优化、性能优化、能耗优化、Legacy (叠加式升级)
Three Hats of OS
The OS manages and shares hardware resources safely, provides convenient abstractions of those resources, and offers common services to applications.
Referee:调控多应用并行
-
隔离 :Dual Mode Execution:普通应用运行在 user mode,OS Kernel 运行在权限更高的 kernel mode,隔离故障 (进程)+隔离内存+隔离 OS 防止侵入。而且 OS 的虚拟内存位置在最高处 (0xFFF…) 一般程序无法读写。
-
资源共享 :现代 OS 可以强制调度 Preemptive Scheduling,即应用不能无限霸占 CPU。
-
通信:隔离进程下需要交换信息提供 Pipes / Sockets 服务。
#include <stdio.h>  // cpu.c
#include <stdlib.h>
#include <sys/time.h>
#include <assert.h>
int main(int argc, char *argv[]) {
    char *str = argv[1];
    while (1) printf("%s\n", str);
    return 0;
}
-
argc,argv是 C 程序接收命令行参数的标准形式,分别接入参数个数、参数数组。如果我们运行该程序:./cpu A,那么 argc = 2,argv[0] = “./cpu”,argv[1] = “A”。 -
%s是 C 标准库函数printf(格式化输出)的格式化字段,代表”将下一个变量作为 C-字符串(以 \0 空字符结尾) 输出”。有多个“%”时依次处理变量。 -
故运行输出为 str 指针指向的第二个参数“A”重复无数遍(A 换行 A 换行 A……)
-
如果运行
./cpu A & ./cpu B & ./cpu C,即启动三个独立进程,现代 OS 运行结果即可能是完全乱序的,比如:A B B A A C B A C A…90年代的 MacOS 9x 和 Windows 3.1及以前的 OS 采用 cooperative scheduling,就会是:A A A A A …
-
如果运行
./cpu & ; ./cpu B,第一个进程 crash了 (Segmentation Fault),但由于进程隔离,B 依旧可以输出:Segmentation Fault B B B B B…。
Illusionist:抽象
OS 通过 virtualization,让应用看不到真实硬件的限制,三种幻觉:
- All alone:独占所有硬件资源——如 virtual CPU
- All powerfull:硬件资源无限——如 virtual Memory (多进程可能有相同虚拟地址)
- All Expressive:提供硬件本身不存在的高级功能——如磁盘并没有文件结构“Users/Nerolithos/…”,诸如 directory, path 等都是 OS 创造的抽象。
int main(int argc, char *argv[]) {  // mem.c
		int *p = malloc(sizeof(int));
		printf("(%d) p: %p\n", getpid(), p);
		*p = 0;
		while (1) {
    	*p = *p + 1;
    	printf("(%d) p: %d\n", getpid(), *p);
		}
    return 0;
}
- 运行时,
malloc()函数申请堆上一段宽为 4B(32b) 的虚拟内存并将 p 指向其首项,然后打印“(进程 ID) p: 指针地址”,再将 p 指向的值赋为 0,随后无限递增并按同个格式输出。 - 如果运行
./memory & ./memory,有可能出现被分配到同个虚拟地址的情况:
(120) p: 0x200000
(254) p: 0x200000
(120) p: 1
(120) p: 2
(254) p: 1
(120) p: 3
(254) p: 2
(254) p: 3
......
这体现出:1、CPU virtualization:多个进程看起来都像在持续运行,实际由 scheduler 交替执行。2、Memory virtualization:不同进程可以看到相同虚拟地址,但背后映射到不同物理内存,互不干扰。
Glue:向应用提供公共服务
每个应用程序不需要自己实现键盘驱动器、磁盘驱动器、网络、文件系统、UI 等等,而是共享 OS 提供的服务。
- Make sharing easier:大家使用统一 primitive。
- Maximize reuse:不用每个程序重新实现网络、文件系统等功能。
- Evolve independently:例如底层网卡更新换代,只要改 OS/Driver,应用程式不受影响。
Evaluation Criteria of OS
Overhead:OS 为了提供抽象额外付出的资源成本不能太贵
Fairness (Equitable):设计合理的资源分配策略
Portability:隔离硬件变化,应用和 OS 都不受硬件配置影响……预测未来的硬件
Reliability:OS 崩溃远比应用崩溃恐怖
Availability:MTTF (Mean Time To Failure)、MTTR (Mean Time To Repair)——越不易坏越好、坏后恢复越快越好
Security:Integrity:OS 不可被 Malware 触及;Privacy:数据只能被授权用户访问
Performance:Response time:完成时间;Throughput: 吞吐率;Predictability:稳定性
Virtual Machine
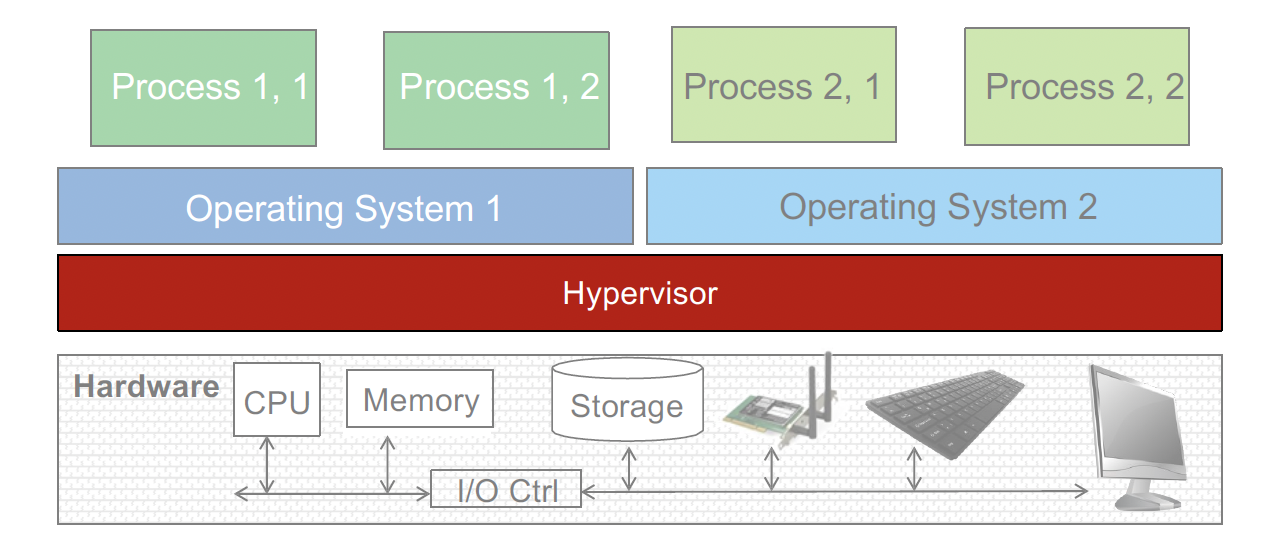
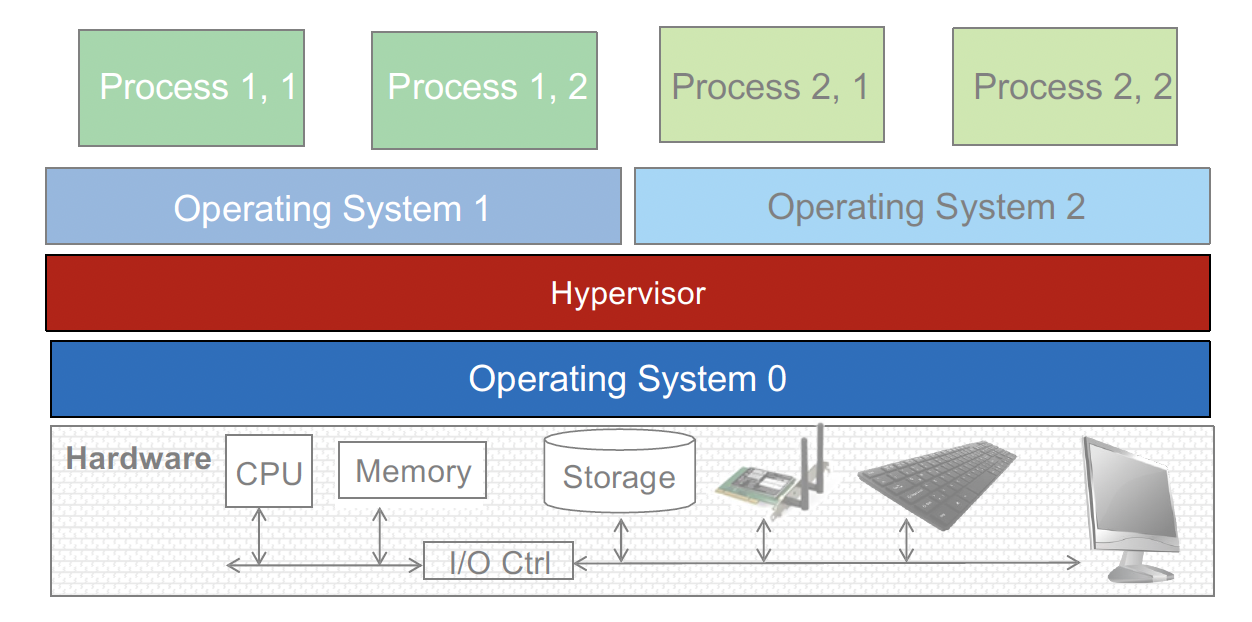
传统虚拟机有两种基础架构,区别在于 Hypervisor (虚拟机监视器 VMM) 运行位置——
OS virtualizes resources for processes;Hypervisor virtualizes machines for (Guest) OS.
Type I Hypervisor (Native)
想象一台强大的物理服务器变成很多台虚拟服务器,常用于云计算。
Hypervisor 直接运行在物理硬件上,宿主不存在操作系统。将硬件虚拟化并提供给客户 OS,多个 OS 都有拥有一台完整计算机的幻觉。并且隔离故障,一个客户 OS 崩溃不会影响其余客户 OS (可是如果它们使用相同 OS/驱动/安全软件,一次有问题的更新可能让它们各自独立地同时崩溃)。
Type II Hypervisor (Hosted)
这是我们日常最容易接触到的“在电脑里开虚拟机”的形式。
Hypervisor 运行在 **Host OS(宿主操作系统)**上,在一个正常 OS 里运行虚拟机软件,再在虚拟机里面运行另一个/另一些 OS。
MacBook
└── macOS                     ← Host OS
    └── VMware/VirtualBox...  ← Hypervisor
        └── Ubuntu Linux      ← Guest OS
            └── Linux 程序
Lecture2 Fundamental Abstractions
回忆 CSC3060 环节…
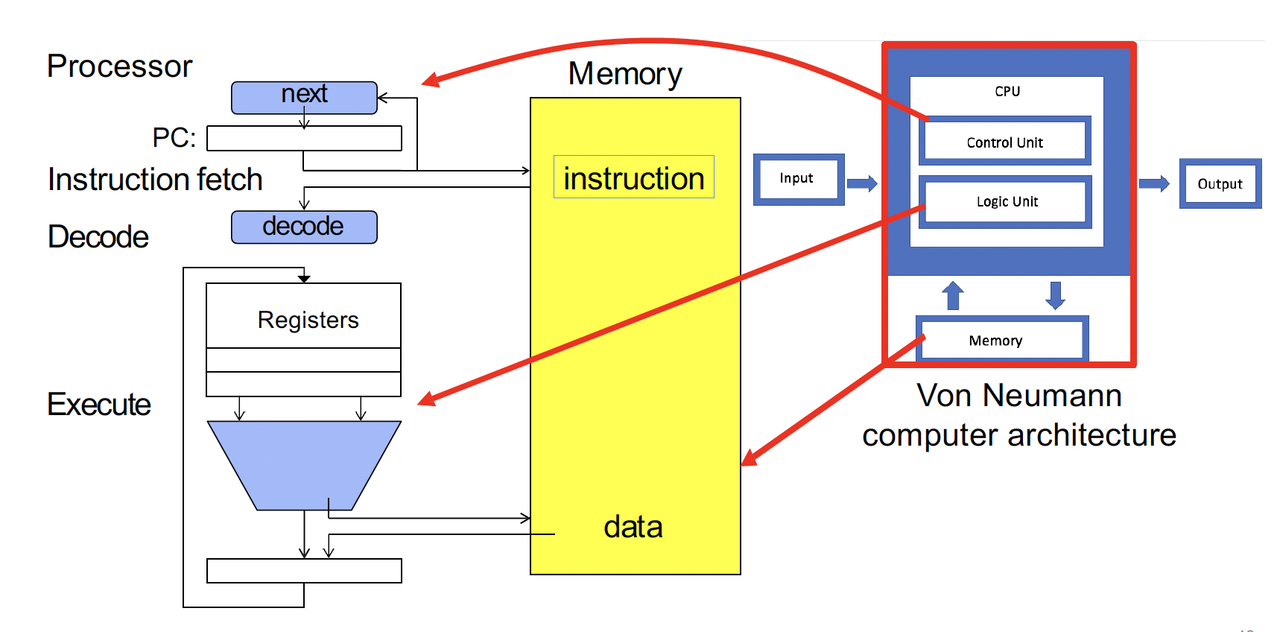
一个 C 程序经过编译器得到 executable后,真正运行时,OS 要把 instructions / data 加载进内存、建立 stack 和 heap、设置 CPU 状态、把控制权交给程序、还要提供服务保护 Kernel 和各进程。
CPU 执行程序遵循老生常谈的 Fetch, Decode, Execute 三阶段——从 Mem[PC] 做 Instruction Fetch,解码,执行 (使用寄存器),写回寄存器/DMEM,PC += 1……循环。
Thread 线程:各自独占 CPU 的幻觉
Thread 是 CPU 中独立 (Single unique) 的执行上下文
- Execution Context:OS 暂停并切换线程时需要保存的状态,诸如——
- PC (保存进度)、Registers (保存计算)、Stack、Execution Flags、Memory State
- 一个重要的寄存器 Stack Pointer 栈指针指向当前 stack 的位置,不同线程通过 SP 指向自己的栈
一个线程“正在执行”本质上是它的 CPU context 此刻被装在 CPU registers 里 (resident in registers)。比如 PC 指向该线程要执行的的下一个指令…
-
“Resident”:寄存器状态保存线程的上下文
-
Context Switch:切换上下文时,OS 复制旧线程的寄存器状态到记忆
-
故在单核处理器上,线程可以通过 context switch 并发 (concurrency),但无法真正并行 (parallelism)。
⚠️ OS 创造虚拟 CPU 并快速切换上下文给每个线程创造独占 CPU 的幻觉 (multiplex in time 时间复用),因此线程是 CPU virtualization 的基本执行单位。
Address Space 内存地址:有序且庞大的幻觉
Address Space 是一个程序可读写的一整套地址及其对应状态
它规定程序可以访问哪些地址,以及访问这些地址实际在硬件上意味着什么。
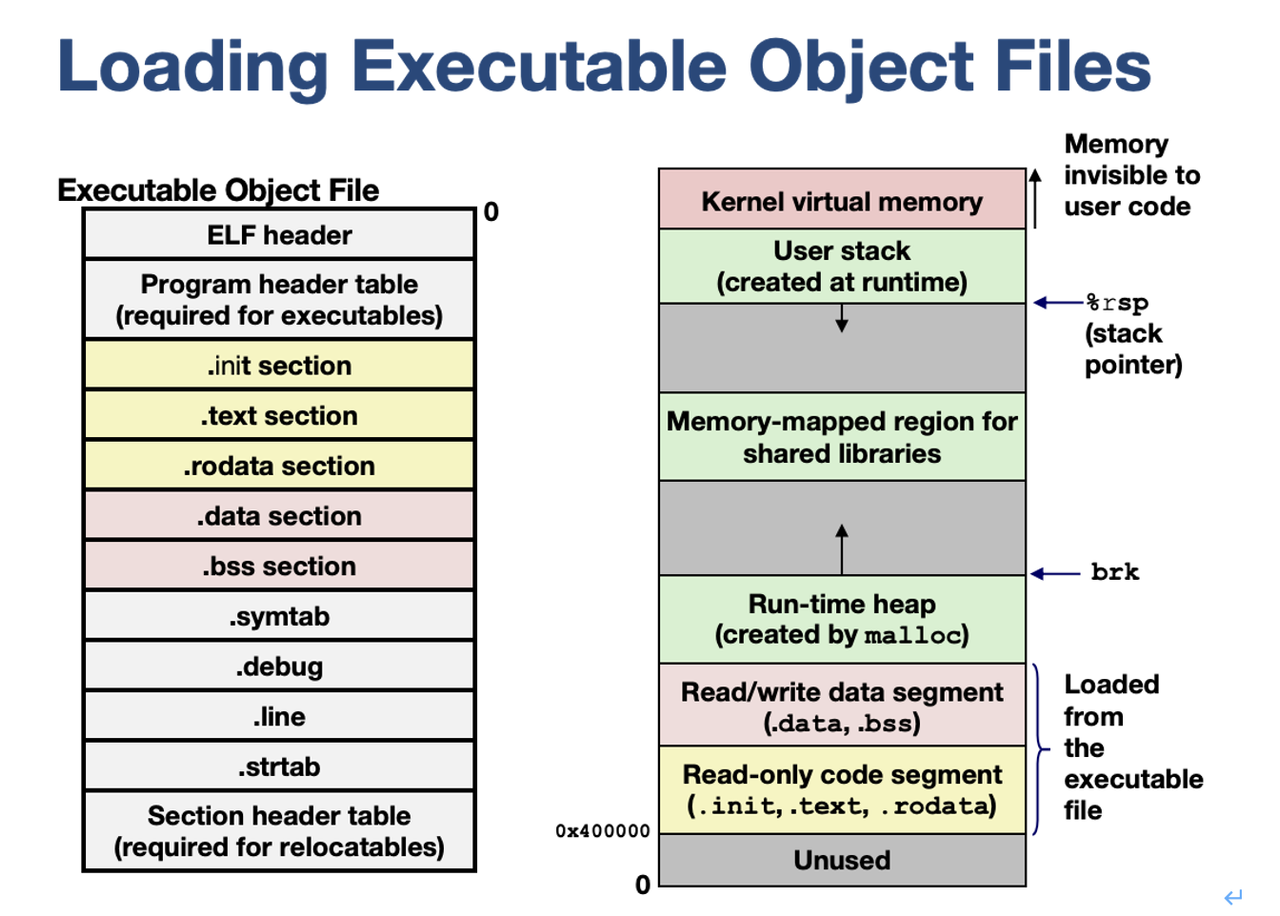
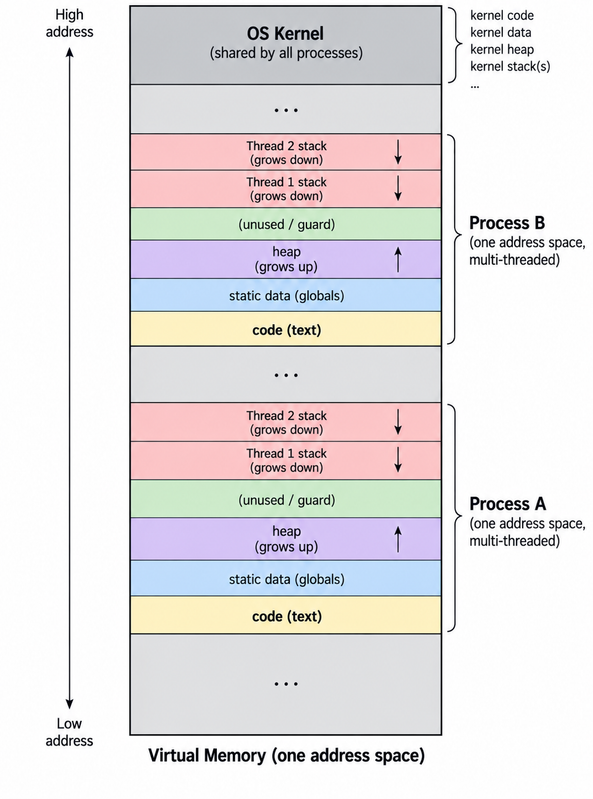
32 位处理器可以表示 232 个地址,约 4x10⁹;64位则有 264 (~1.8x10¹⁹),地址从 0 到 0xFFF…F。下图借用 CSC3060 课件展示虚拟地址分配:
-
Code Segment 和 Static Data Segment 都从 exe 文件加载,前者是机器指令 (PC 指向的 IMEM),后者是 global variables 和 static variables (非临时变量)。
-
Stack 主要负责函数执行状态,比如方法 (包括 main()) 中的临时变量。每个线程都有自己独立的 Stack,用于 function calls、local variables、ra。
-
Heap 是用
malloc(<int>)动态内存分配区域。⚠️ 如果让一个指针 (临时变量) 执行分配的区域,指针本身还是存在栈上。编程时需要手动清理 Heap。
int global_var = 10;  // Static Data
void stack_function() {
		int stack_var_in_func = 30;  // Stack
		printf("Address of stack_var_in_func: %p\n",(void*)&stack_var_in_func);
}
int main() {
		int stack_var = 20;  // Stack
		int *heap_var = (int*)malloc(sizeof(int));  // 指针在 Stack,指向 Heap
		if (heap_var == NULL) {
			fprintf(stderr, "Failed to allocate memory on the heap\n");
			return 1;
		}
    *heap_var = 40; // Storing a value in the heap memory.
		// The programmer is responsible for freeing heap
		memory.free(heap_var);
		return 0;
}
回忆 CSC3200/3060 的 * & 地狱:
(dt*)表示强转换为 dt 数据类型;
dt * x/dt* x/dt *x表示声明 dt 类指针,const dt* x常量指针、dt * const x指向常量的指针、const dt* const x指向常量的常量指针
int *p = &x:声明指针 p 指向 x 取地址后的结果古代神秘召唤仪式:
const int (* const f)(const int *) = &function
// 初始化一个指向一个接受“指向整常量的指针”作为参数并输出整常量的函数function的常量指针f……
const int *f(const int *) {...}
// 声明一个接受“指向整常量的指针”作为参数并输出“指向整常量的指针”的函数f……
C 没有引用
Process 进程:各自独占机器的幻觉
Process 是一个程序的受限权限的运行环境,= (Some) Address Space + Threads (≥1)
进程还拥有虚拟内存、file descriptors、file system context、sockets 等的访问权
进程给每个程序划定一个边界,防止互相干扰或侵入 OS Kernel:
- Fairness:OS 控制每个 process 能拿到多少 CPU time、Mem、I/O、disc…
- Security and Privacy:恶意程序不能读写其他进程
- Reliability:bug 无法跨进程造成内存损坏
- Primary mechanism: 限制虚拟空间到物理内存的映射 (translation),线程和进程都只能碰进程的虚拟内存空间
Threads encapsulate concurrency, Address spaces encapsulate protection.
进程提供 address space,线程提供 execution flow。
Multiprogramming:Multithreading 多线程
单进程多线程 (Multithreading):共享同一进程的虚拟地址空间,独立保存执行状态 (PC + Registers + SP + Stack),以实现——
-
并行 (parallelism):实现多核处理器等硬件并行
-
并发 (concurrency):OS Context Switch (Virtual CPU) 交错推进
OS 控制 CPU 保存旧线程 PC, SP, regs 到内存,载入新线程 PC, SP, regs
切换原因:Timer (Preemptive Scheduling)、Voluntary yield (cooperative scheduling)、I/O (比如读写磁盘等超慢指令出发切换)……
如果没有 Process 呢?
Embedded applications、Windows 3.1/早期 Macintosh (yield switch)、Windows 95–ME (yield/timer switch) 中简单的使用 Type II VM + Multiplexing 进行 Multiprogramming (Concurrency)——线程和 vCPU 是直接共享内存 (包括指令) 和 I/O 设备的,但越易共享越难安全。
Dual Mode Operation 两种运行层级
⚠️ 硬件至少用 1 bit 表示并提供两种运行模式:
-
Kernel Mode (Privileged/Supervisor Mode)
-
User Mode:Standard Libs & Applications 无法直接接触硬件、无法读写 OS Kernel memory、无法改变 Page table pointer、无法拒绝切换线程或 interrupt 等等
应用通过 Syscall (System call) 借助 OS 间接调用硬件,同样跨模式的操作还有 interrupts 和 exceptions (后文展开)
Memory Protection:B&B and Addressing
进程将 Base 设为其分配的最小映射地址,Bound 设为最大,保证任何内存访问满足:Base ≤ address < Bound。从而实现 Isolation 并保护 Kernel
两种虚拟地址:
-
Load-time relocation:程序在加载时,把地址直接调整到它最后真正放置 (物理硬件上) 的位置。需要重定位 Loader,但执行时不一定每次访存都做动态加法
-
Address space translation:虚拟地址不等同于硬件地址,由 translation hardware 决定最后访问哪一个 physical address。运行时 (on-the -fly) 动态通过加偏移量计算物理地址
⚠️ B&B Registers 必须是 Kernel Mode 的,由 OS 管理
假设 OS 要运行进程 P1,首先处于 Kernel mode (sysmode = 1),OS 设置 B&B、user PC、registers;然后 OS 运行 RTU (return to usermode),切换为 sysmode = 0,同时 CPU 开始执行 user program……但是如果要打断/调用硬件/切换上下文就需要切回 mode1,为了控制风险,有三种 transfer——
- Syscall:由进程主动发起 OS 服务的特殊指令,例如
read()、write()、exit()、fork()(internal, active, synchronous) - Interrupt:由外部 Timer 或 I/O 设备等硬件独立于进程发起 (external, passive, asynchronous)
- Trap/Exception:CPU 在执行进程的某条指令时检测到异常条件并触发控制转移到 OS Kernel,例如 divide-by-zero、page fault、invalid instruction、protection violation 等(internal, synchronous)。
⚠️ 安全起见,三者皆为 UNPROGRAMMED control transfer,即运行中的进程切换到 OS 无需也无法给出 Kernel “目标地址”参数,进程无法随意指定跳到 kernel 的具体位置。OS 通过维护一张 Interrupt Vector 表,如果产生 i 打断码,CPU 查询 vector[i] 获得 interrupt handler address,然后进入 kernel 执行:intrpHandler_i () {...}。
Lecture3 Threads and Processes
Multiplexing: Concurrency 时间复用:并发
上回说到……
并发:假设 OS 要运行进程 P1,首先处于 Kernel mode (sysmode = 1),OS 设置 B&B、user PC、registers;然后 OS 运行 RTU (return to usermode),切换为 sysmode = 0,同时 CPU 开始执行 user program;Timer Interrupt 切回 mode1;随后 OS 先将 P1 的 CPU states (registers) 存到 Memory 然后设置 P2 的状态……
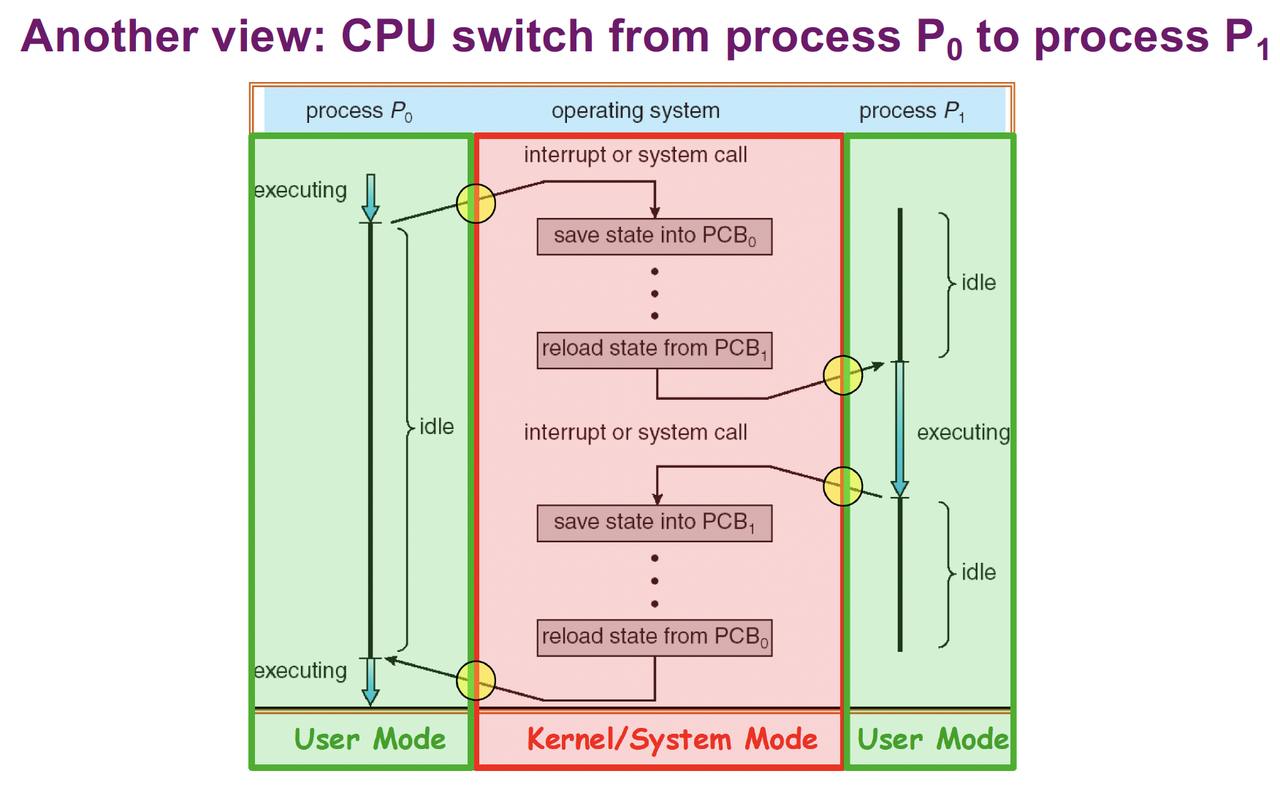
切换上下文时,如何“打包”进程状态然后另存起来?
PCB 进程控制块
OS Kernel 为每一个进程建一个数据结构 Process Control Block,Kernel Scheduler 建立一个保存所有 PCB 的数据结构并掌握把 CPU 切给各个进程的策略:
  Kernel PCB of P1            CONTEXT SWITCH
┌────────────────────┐          P1 running
│ PID = 1234         │              │
│ status = READY     │        timer interrupt
│ PC = 0x1234        │              ↓ Interrupt (sysmode 0→1)
│ SP = 0x00FF        │            Kernel
│ R1 = 8             │              │
│ R2 = 27            │        save P1 → PCB1
│ ...                │              │
│ Mem limits/trans.  │          Scheduler
│ priority           │              │
│ execution time     │          choose P2
└────────────────────┘              │
                                load PCB2
                                    ↓ RTU (sysmode 1→0)
                                P2 running
status 包括 Running/Ready/Blocked…;非 ready 状态下保存寄存器状态
切换上下文时,如何决定切给哪个进程-线程?
Scheduler 调度器
Mechanism (机制):如何切换
if (readyProcesses(PCBs)) {
    nextPCB = selectProcess(PCBs);
    run(nextPCB);
} else run_idle_process();
Policy (策略):确保 Fairness、Latency 优化、Realtime Guarantees…
P1/P2/P3... 到底选谁?
每个跑多久?谁优先?
Threads
OS 切换进程实现并发,那为何进程还需要多个线程?线程拥有什么资源/数据。
线程是独立的执行上下文,也是调度器可以独立调度的执行流,还是并发的机制 (Mechanism),以及多核处理器并行的最小单位。
并行与并发的区别是前者 CPU 硬件上同时有多个线程运行,后者同时只有一个线程在 CPU 运行。所以单核无法并行,并发无需多核。
-
Multiprocessing = Parallelism = Simultaneous Execution = PLP
-
Multiprogramming = Concurrency = Overlapping Execution
线程存在的意义在于其“独立”性:
main() {
data = read_from_disk();
calculate();
}
如果没有线程,calculate 要一直等着,因为前一个指令 (I/O) 是千万纳秒级别的:
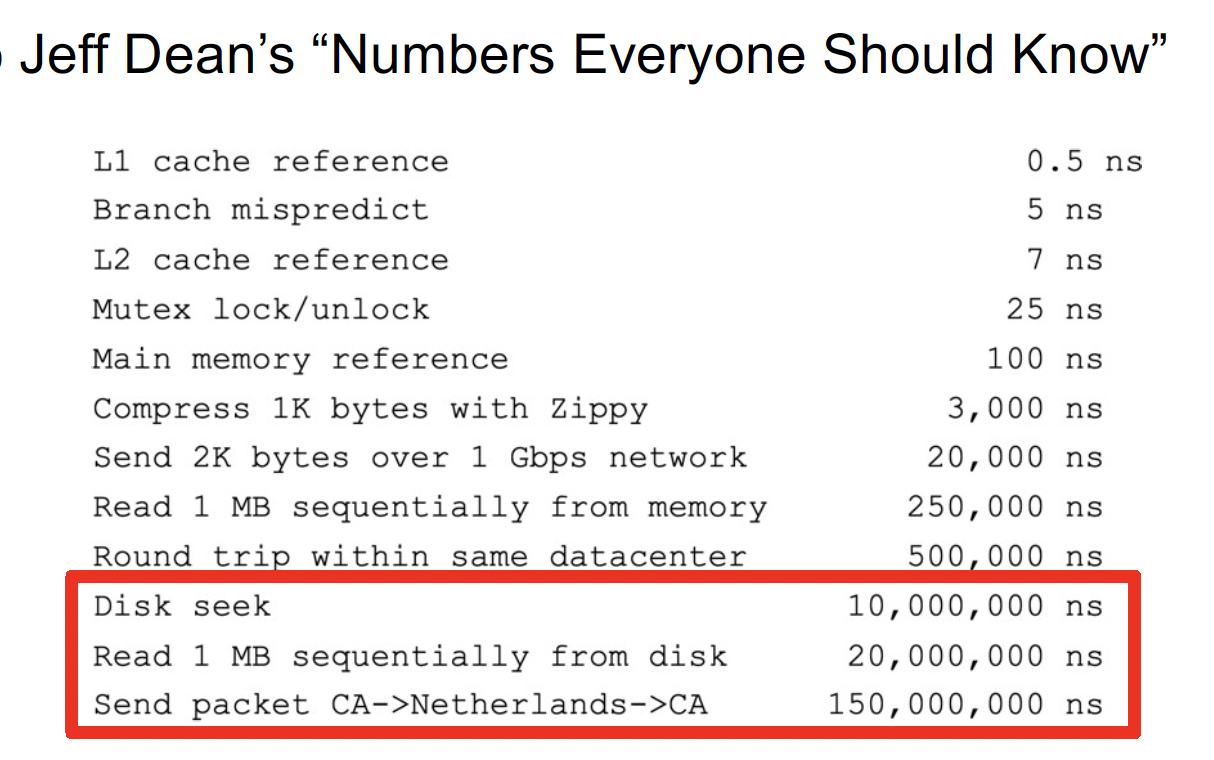
但既然两个任务是独立的,分为两个线程 T1 和 T2,创造每个线程各自独占一个 CPU 的幻觉。这样将 I/O 作为独立线程,就可以隐藏其 Latency——线程相当于进程执行时的防堵车系统。
Multithreaded Process 多线程进程
当 C 程序被编译并运行后,该程序的进程被建立,进程中只有一个 initial thread 在其地址空间中,进程在运行期通过 Syscall 调用 OS 创建线程。这些线程都共享进程的地址空间、代码、堆、全局/静态数据,拥有自己的栈。
Syscall、Interrupt、Exception/Trap 都是由 User mode 转为 Kernel mode 的 UNPROGRAMMED 命令。你不会在 C 程序中手写它们。程序运行时通过 OS Library 提供的 API 发起 Syscall:
C 程序 → libc / runtime wrapper → syscall instruction → kernel
⚠️ C 程序默认从一个 main thread 开始。你不手动创建线程/进程,也不使用替你并行化的 runtime/library,就不可能有程序级 TLP;但 CPU 仍然可能在单线程内部利用 ILP、流水线、乱序执行、SIMD 等硬件并行。C 语言不会因为机器有 10 个核,就自动把你的顺序程序拆成 10 个线程。
三个重要的线程相关 API——pthread:
int pthread_create(
    pthread_t *thread,
    const pthread_attr_t *attr,
    void *(*start_routine)(void *),  // 一个指向“接受void*参数并返回void*”的线程函数的指针
    void *arg
);
pthread_create(..., worker, arg);相当于创建一个线程从worker(arg)开始执行attr包括栈大小,scheduling policy 等信息- create 后,join 不会再修改
pthread_t thread
void pthread_exit(void *value_ptr);
// pthread_exit(v); 当前线程结束后交接 v 给下一个成功 join 的线程
// 如果没有传出数据用 NULL
int pthread_join(pthread_t thread, void **value_ptr);
// pthread_join(t, &result);
// 当前线程等待 t 线程 exit,如果成功 join 则接收传递的 result 的地址
-
线程函数里
return v;效果相当于隐式调用pthread_exit(v)来结束当前线程。进程(比如 main())的返回值只传整数状态码,就是因为不同于线程,进程间不共享内存地址,它们通过 socket/pipe 共享。
-
join 的第二个传参接收前序 exit 线程的传出数据,由于线程共享地址空间,使用指针的指针可以修改这个传出变量。
void *worker(void *arg) {  // 线程函数声明该线程执行什么代码
    printf("hello\n");
    return NULL;  // 终止线程
}
int main() {
    pthread_t t;
    pthread_create(&t, NULL, worker, NULL);
    pthread_join(t, NULL);
}
Fork-Join Pattern
Fork = Main Thread 把独立工作分出去并发 Work; Join = 等这些工作全部完成,越过汇合点后 main 收集结果并继续。
问题:如果多个线程会读写进程的同一个变量,不加限制 (locking) 的话结果就不确定——Race Condition
Thread State
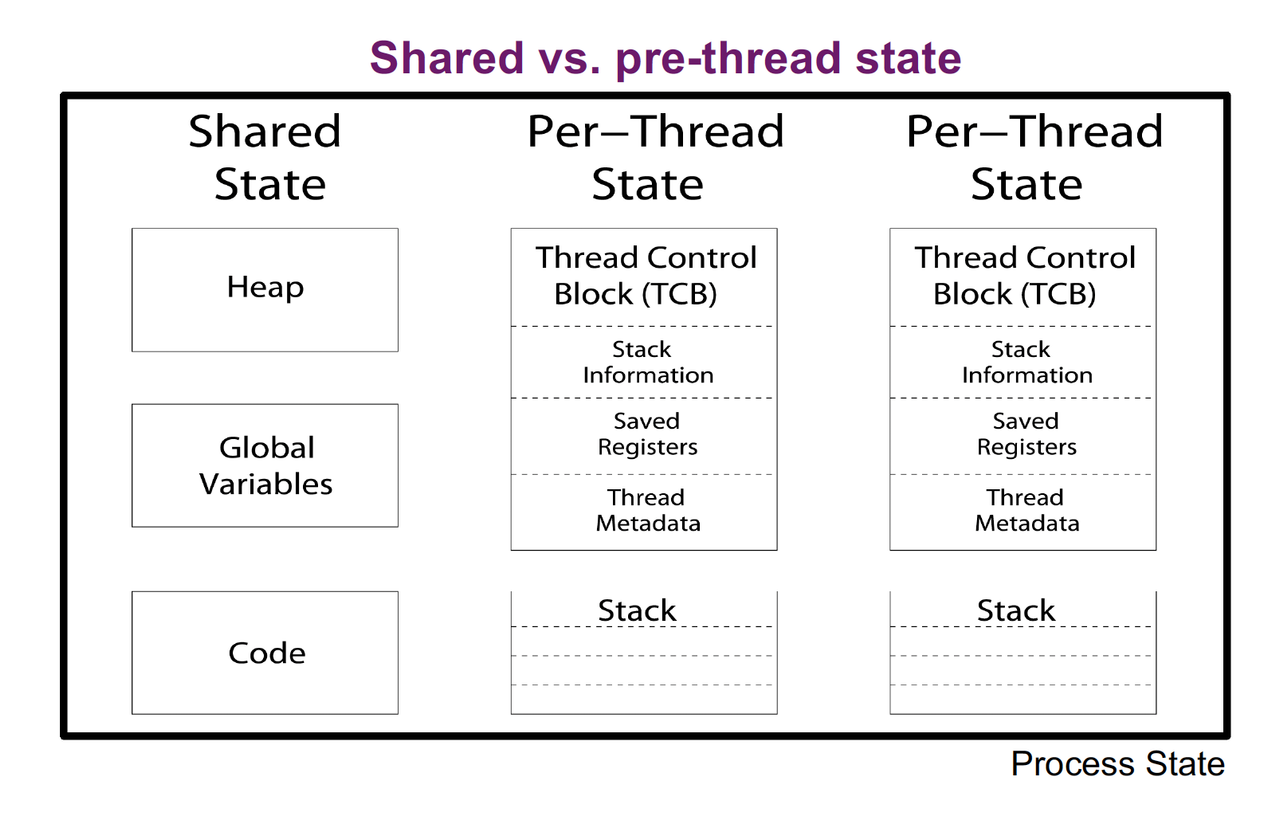
同一个 process 的 threads 共享:Code + Global Variables + Heap + I/O state/files + Open File Table + Address Space(B&B Register) + Page Table
但是每个 thread 私有:TCB{Registers (including SP/FP)、PC、Thread metadata} + Execution Stack
(Thread 私有状态除了 Stack 都装在 TCB (线程控制块) 中)
调用函数时,要暂存“回来以后从哪继续执行”,这种地址即 Return PCs (RA) 通常存在 stack 中:
-
DFS ≡ Stack ≡ LIFO 出入栈天然适合处理函数递归调用的
BFS ≡ Queue ≡ FIFO
-
所有尚未返回的函数调用都需要保留各自的 RAs,通常保存在该线程自己的栈中
-
发生 thread context switch 时,OS 保存当前线程的 PC、SP、registers 等 CPU context;stack 本身仍然留在内存中,不需要把整个 stack 复制/保存一遍
| 性质 | 调用函数执行期间 | 函数调用/返回时 | |
|---|---|---|---|
| SP | 寄存器 | 经常变化 | 变化,持续指向栈顶 (最小内存地址) |
| *FP/BP | 寄存器 | 通常固定 | 切换到新 frame |
| Stack Frame | 一段内存 | 当前调用期间存在 | call 创建,return 后释放/失效 |
| PC | 寄存器 | 几乎每条指令都变 | call/return 会明显改变 |
| RA | 返回地址 | 对一次调用而言固定 | 每次 call 产生新的 RA |
(现代编译器不一定用 FP,通过 SP 固定偏移确定帧地址)
A(int tmp) {                  ┌─────────────┐ A
    if (tmp < 2) B();      ↓  │ tmp = 1     │
    printf(tmp);              │ ret = exit  │
}                             ├─────────────┤ B
B() {                         │ ret = A+2   │
    C();                   ↓  ├─────────────┤ C
}                             │ ret = B+1   │
C() {                         ├─────────────┤ A
    A(2);                     │ tmp = 2     │
}                          ↓  │ ret = C+1   │
A(1);                         └─────────────┘ ← SP
调用关系:exit—入栈→A(1)→B→C→A(2)—出栈→C→B→A(1)→exit
输出结果:2 1
-
线程运行时 SP 在 CPU 寄存器中,指向内存中该进程的栈顶;
-
线程切换时 SP 等 execution states 被存到 Kernel Memory-TCB 中
Scheduler 真正切换的执行上下文通常是 thread
Process 更多代表:资源/保护/地址空间的容器
Thread 更偏向于:CPU 执行/调度的基本单位
Lecture4 System Programming: Processes
Interleaving & Nondeterminism
硬件上多条执行流 (Threads) 交错执行注定了程序必须适应任何 schedule——
- scheduler 可以按任意顺序运行线程;
- scheduler 可以在某线程运行到任意时刻切换;
- 因而测试 concurrent programs 很困难。
Independent Threads:互相不共享任何状态 (代码层面:不修改同个变量),反之就是 Cooperating Threads,如无有意设计可能得到多种 interleaving 执行结果 (Race Condition)。
- 如下情况 x 的执行结果有多种可能:1,3,5
         Process 1
int x = 0; int y = 0;
Thread 1          Thread 2
x = y + 1;        y = 2;
                  y = y * 2;
- 类似的,非原子操作 (non-atomic op.) 可能执行出多个结果:
         Process 2
int c = 1;
Thread 1          Thread 2
c++;              c++;
Increment 对于 CPU 相当于 read、add、write 三个指令,在指令间切换的导致结果可能是:2 或 3
- 共享数据结构则更危险,尤其是操作步骤多的树,可能在中间步骤切换导致出现结构 (指针/节点) 损坏或得到不合理结果。
Scheduler 是 nondeterminism 的,故要在设计程序时保证稳定准确 (deterministic)。
Relevant Definitions
-
Synchronization:协调多线程执行(主要是共用数据)
-
Mutual Exclusion (Mutex):一种 synch.,某件事情同时段只能有一个线程做,用于保护关键代码
-
Critical Section:同时段最多允许一个线程执行的代码区域 (护持保护的代码)
-
Lock:同时段只能由一个线程持有的 object,用于实现 Mutex。提供两个原子操作——
lock.acquire():等 lock free 后,调用该指令的线程占有 lock (hold the lock);lock.release():占锁的线程调用以释放 lock。在 CS 前后加 lock 指令使后续线程无法打断正在执行的线程。因此不会 overlap。
(暂不讨论如何实现 lock,但显然从线程角度,它绝不可被拆成多个步骤:
.acquire must be atomic)
OSlib Pthread 里实现真正的 Mutex:
int pthread_mutex_init(pthread_mutex_t *mutex, const pthread_mutexattr_t *attr);
// 初始化
int pthread_mutex_lock(pthread_mutex_t *mutex);
// acquire
int pthread_mutex_unlock(pthread_mutex_t *mutex);
// release
应用时比如:
pthread_mutex_t lock;
void *worker(void *arg) {
    pthread_mutex_lock(&lock);
    common++;
    pthread_mutex_unlock(&lock);
    return NULL;
}
Processes …… Again
⚠️ Everything outside of the kernel is running in a process
比如在终端里输 ls,kernel 不会凭空生成一个 list directory 进程——实则 shell 本身就是一个进程,向 kernel 发起 Syscall 并创建 ls 进程!
也就是说:进程可以创建进程,进程可以管理进程
Process Management APIs (Unix)
-
exit结束当前 process(类比void pthread_exit) -
fork复制当前 process,产生一个新的 child process(类比int pthread_create)注意 Thread 的 fork-join pattern 泛指“分叉产生并发任务”,和 Unix Process API 的 fork() 不可混为一谈
-
exec把当前 process 正在运行的 program 换掉 -
wait等待 process 结束(类比pthread_join) -
kill给另一个 process 发 signal (interrupt-like-notification) -
sigaction设置收到某种 signal 后怎么办
exit()
int main(int argc, char *argv[]) {
    pid_t pid = getpid();  // PID 是 OS 给进程的标识
    printf("My pid: %d\n", pid);
    exit(0);
}
-
exit()终止整个进程,接收一个整数进程退出状态码:void exit(int status); -
由于
main()函数是程序入口,它返回后程序结束,OS Library 会帮用户exit()——exe 文件的入口 (entrypoint) 在 OS lib 中,故它会调用 main 并在其返回后调用 exit。这解释了为何 main() 函数永远输出 int:
int main()⚠️ 这和线程中的线程函数 (thread start routine)
return相当于隐式pthread_exit结构上形成对应关系 -
⚠️
return代表退出当前函数,而exit()可以在程序调用栈的任何位置直接终止整个进程。比如 main 调用函数时出现异常/故障/缺失:void load_config() { FILE *f = fopen("config.txt", "r"); if (f == NULL) exit(1); // 整个程序的进程到此终止 // ...
⚠️ fork()
pid_t fork(); 复制当前进程,对应所谓“进程可以创建进程”
- 新进程拥有不同的 PID,并初始拥有一个线程
fork()后,产生的子进程得到 parent 在 fork 那一刻的进程状态副本,包括 Address Space、File Descriptors、代码数据堆栈寄存器 PC 等。⚠️ 但 OS 对两者虚拟地址 mapping 不同,实际物理地址分离,后续读写互不影响
printf("A");
fork();
printf("B");
对于上述代码,输出结果一般是 A B B,因为 fork 后父子进程都从同一位置继续执行 (谁先输出不确定)。
⚠️
fork()最精妙的设计在于用 2 个返回值 (pid_t PID) 识别 parent&child!
比如 cpid = fork();
- 如 cpid > 0,可以确定这段代码一定在 parent 进程中执行,且 cpid 就是子进程的 PID
- 如 == 0,则可确定在新产生的子进程中运行
- 如 < 0,那没有成功 fork 出子进程,只存在原进程
parent 进程调用 fork(),返回时父子进程都会返回,得到两份 cpid,所以 fork() return TWICE
parent 需要知道 child PID 以方便对它 kill、wait,而 child 只需通过 getpid() 就可以查自己的 PID——
parent 得到 Child 的 PID;Child 得到 0 这个 “我是 Child”这个标记。
pid_t cpid, mypid;
pid_t pid = getpid();
printf("Parent pid: %d\n", pid);
cpid = fork();
if (cpid > 0) {
    mypid = getpid();
    printf("[%d] parent of [%d]\n", mypid, cpid);
}
else if (cpid == 0) {
    mypid = getpid();
    printf("[%d] child\n", mypid);
}
输出结果有两种(由于调度器并发):
Parent pid: 100            Parent pid: 100
[100] parent of [101]      [101] child
[101] child                [100] parent of [101]
这种 race 和线程的不一样 (不存在 shared memory data race),因为进程中的执行顺序是固定的,但父子两个进程的线程可以并发交替:threads concurrently execute——两个 process 的输出顺序可能交替。
创造线程 vs 创造进程
| Threads | fork() 后的 Processes |
|
|---|---|---|
| Global data | 共享 | 独立 |
| Heap | 共享 | 独立 |
| Stack | 各自 | 各自 |
| Address space | 同一个 | 不同 |
| PID | 同 process | 不同 |
int i;
pid_t cpid = fork();
if (cpid > 0) {
    for (i = 0; i < 10; i++) {
        printf("Parent: %d\n", i);
        // sleep(1);
    }
} else if (cpid == 0) {
    for (i = 0; i > -10; i--) {
        printf("Child: %d\n", i);
        // sleep(1);
    }
}
在各个进程的输出间加 sleep() 可以让输出更容易交错,但不能保证如此,因为 sleep 只是让进程/线程暂停,并无 synchronization 的功能。
(Windows 使用 CreateProcess() 代替 fork(),接口更复杂)
exec() & wait()
execv("/bin/ls", args); 标识把当前进程执行的程序替换成 ls,不创造新进程——PID 不变但代码数据堆栈都变。
char *args[] = {"ls", "-l", NULL};
execv("/bin/ls", args);
/* execv doesn’t return when it works.
   So, if we got here, it failed! */
perror("execv");
exit(1);
exec 正常运行时进程运行的程序从当前程序切走,所以如果它返回且执行下一行,必然出错了。
显然,shell 进程不能直接 execv() 任何指令,否则 shell 自身的程序就被干掉了。必须 fork() + child execv()。并且 shell 为了显示指令 (如 ls) 输出结果,必须等待这个子进程运行结束。整个逻辑串起来:
int status;
pid_t tcpid;
cpid = fork();
if (cpid > 0) { /* parent process */
    mypid = getpid();
    printf("[%d] parent of [%d]\n", mypid, cpid);
    tcpid = wait(&status);  // tcpid 为等的子进程的 PID
    printf("[%d] bye %d(%d)\n", mypid, tcpid, status);
} else if (cpid == 0) { /* Child Process */
    mypid = getpid();
    printf("[%d] child\n", mypid);
    char *args[] = {"ls", "-l", NULL};
    execv("/bin/ls", args);
}
假设 parent 和 child ID 分别为 100 和 101,前者先输出 [100] parent of [101] 然后等待;后者输出 [101] child 然后输出当前目录的文件列表;正常输出结束后,前者输出 [100] bye 101(0)。⚠️ 实际输出时前两个输出顺序不保证。
wait(&status):等任意一个 Child (最早结束者)
waitpid(pid, &status, 0):可以指定等哪个 Child
kill() & signaction()
Signal 是发给进程的非硬件异步 (asynchronous) 通知
#include <signal.h>
void signal_callback_handler(int signum) {
    printf("Caught signal!\n");
    exit(1);
}
int main() {
    struct sigaction sa;
    sa.sa_flags = 0;
    sigemptyset(&sa.sa_mask);
    sa.sa_handler = signal_callback_handler;
    sigaction(SIGINT, &sa, NULL);
    while (1) {}  // 正常执行
}
向 OS 注册一个 signal handler::“如果我收到 SIGINT (CTRL-C),不要按默认方式处理,请调用 signal_callback_handler()”
如果不注册 handler,按照默认,进程直接死。
- SIGINT (interrupt):CTRL-C
- SIGTERM (terminate):shell 默认
kill PID - SIGSTOP (stop/pause):CTRL-Z
- SIGKILL (进程 不能捕获、不能忽略、不能自定义 handler) 可靠的强制终止
-
Threads:共享方便,但 synchronization 困难
-
Processes:隔离更强,但 communication 更麻烦